简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
NVIDIA Spark 4台で自前運用するDeepSeekの実測:Crazyrouter V4.1 Flash 1017ベースラインとの比較
2026年11月3〜4日の実測記録をもとに、NVIDIA Spark 4台で自前運用したDeepSeekとCrazyrouter V4.1 Flash 1017ベースラインを比較。短・長入力の速度、キャッシュ、夜間の中断、直接接続とゲートウェイ経由の遅延を検証した。自前運用側の重みの同一性は未確認。
NVIDIA Spark 4台でDeepSeekを自前運用した場合、実際の呼び出し性能は既存のAPIにどこまで近づくのでしょうか。2026年11月3〜4日のテスト記録を振り返りました。同じ回の比較ではCrazyrouterベースラインの出力が速く、その後のSparkの測定結果は時間帯によって大きく変わりました。低負荷時と混雑時では、利用時の体感に大きな差がありました。
11月3日に同じ回で行った少数サンプルのテストでは、Crazyrouter DeepSeek V4.1 Flash 1017ベースラインの出力速度の中央値は短入力で147.31 token/s、長入力で136.87 token/sでした。Spark 4台の自前運用ではそれぞれ41.46 token/s、10.02 token/sでした。速度測定のリクエストは両者とも6/6件完了しました。1
この記事では、デプロイ後の呼び出し性能を扱います。最初の出力までの待ち時間、ストリーミング出力の速度、同じコンテキストを繰り返した場合のキャッシュヒット、混雑時にテストの制限時間内でリクエストを完了できるかを確認します。データは過去のアーカイブに基づきます。11月20日に再測定した結果ではなく、現在のサービス状態を保証するものでもありません。 以下の時刻はすべて北京時間です。
1017ベースラインとSparkの自前運用は同じバージョンか?#
対象のモデルシリーズについてはCrazyrouterのDeepSeekモデルページ、Sparkの製品情報についてはNVIDIA DGX Sparkの公式ページを参照できます。各ページは参考資料であり、過去の性能評価は本記事のテスト記録に基づきます。CrazyrouterのDeepSeekモデルページ · NVIDIA DGX Spark公式ページ
当時、両側へのリクエストで指定したモデル名は deepseek-v4.1-flash でしたが、レスポンスに含まれるモデル名は異なっていました。
| 比較対象 | レスポンス内のモデル名 | 当時確認できたこと |
|---|---|---|
| CrazyrouterのDeepSeekベースライン | deepseek-v4.1-flash-1017 | レスポンスの識別子に1017のサフィックスが付いていた |
| Spark 4台で自前運用するDeepSeek | deepseek-v4.1-flash | 4台のGB10ノードすべてで推論のrankプロセスが動作していた |
当時の資料には、自前運用側の重みのハッシュ、正確なリビジョン、量子化設定が完全には記録されていません。そのため、本記事で DeepSeek V4.1 Flash 1017 と表記するのは、ベースラインのレスポンス識別子を指す場合に限ります。両側で同一の重みを使っているかは未検証です。レスポンス内のモデル名だけでは重みの同一性を検証できません。2
「NVIDIA Spark deepseekv4.1flash1017 自前運用」で検索する際は、互換インターフェースを提供できることと、まったく同じバージョンのモデルが動作していることの確認では、検証すべき項目が異なります。 本記事では当時実際に使われた2つのサービス経路を比較しています。すべての変数をそろえたGPUハードウェア性能の順位付けは行っていません。
テスト方法:共通の入口、固定チャネル、固定の出力上限#
11月3日の主テストでは、同じCrazyrouterの入口から2つの固定チャネルを呼び出しました。片方はベースラインのサービスに、もう片方はSpark 4台で自前運用するサービスにつながっています。ほかのチャネルのレスポンスは結果に含めず、テスト中にチャネル設定も変更しませんでした。
当時のテストで実際に使用したアドレスは以下のとおりです。
Base URL: https://crazyrouter.com/v1
Endpoint: POST /chat/completions
Model: deepseek-v4.1-flash
以下は測定に使った主な設定の抜粋です。実際のリクエストには、共通のタスク本文と、測定回を区別するためのプレフィックスも含まれていました。
{
  "model": "deepseek-v4.1-flash",
  "stream": true,
  "temperature": 0,
  "max_tokens": 768,
  "thinking": { "type": "disabled" }
}
短入力は 64 token、長入力は 6,230 token で、それぞれ3回実行しました。長入力ではキャッシュの挙動を確認するため、同じ本文を繰り返し使いました。前のリクエストが終了してから次のリクエストまで6秒空けました。チャネル間では並行してテストし、同一チャネル内ではリクエストを順番に送信しました。
当時のテスト全体では4チャネルに対して本測定のリクエストを26件送信しました。本記事ではベースラインとSparkの 12件 を取り上げます。残る2チャネルは結果の範囲を確認するために使い、別途1回行ったスモークテストは集計から除外しました。本測定の全リクエストについて、利用ログと照合してチャネルとトークン数を確認しました。
主テストでは全リクエストが768 tokenを出力し、推論トークンは0でした。ここでの「完了」は、ストリームが最後まで正常に終了し、使用量の記録を受信したことを指します。出力上限に達して終了したことを示す finish_reason=length は、今回の速度測定では想定どおりです。6/6という完了数は応答の受信に関するもので、回答の正答率や、モデルが業務タスクを自然に終えたかどうかは示しません。
時間は2種類に分けて集計しました。最初の出力までの待ち時間は、クライアントがリクエストを送信した時点から計測します。出力速度は、出力トークン数を本文の最初のチャンクから最後のチャンクまでの経過時間で割って求めました。この速度はクライアント側の概算値で、最初のチャンクのトークンも分子に含みます。それ以前の接続やキューでの待ち時間は含みません。表の値には、各条件で行った3回の測定の中央値を用いました。1
同じ回の測定結果:短入力では最初の出力までの待ち時間が近く、その後の出力速度には大きな差#
| 指標 | Crazyrouter 1017ベースライン | Spark 4台の自前運用 |
|---|---|---|
| リクエスト完了数 | 6/6 | 6/6 |
| 短入力での最初の出力までの待ち時間(中央値) | 3.31 秒 | 3.25 秒 |
| 短入力での出力速度(中央値) | 147.31 token/s | 41.46 token/s |
| 短入力での総所要時間(中央値) | 9.05 秒 | 21.78 秒 |
| 長入力での最初の出力までの待ち時間(中央値) | 3.36 秒 | 7.73 秒 |
| 長入力での出力速度(中央値) | 136.87 token/s | 10.02 token/s |
| 長入力での総所要時間(中央値) | 9.09 秒 | 84.40 秒 |
| 最も遅かった1件の総所要時間 | 10.26 秒 | 156.11 秒 |
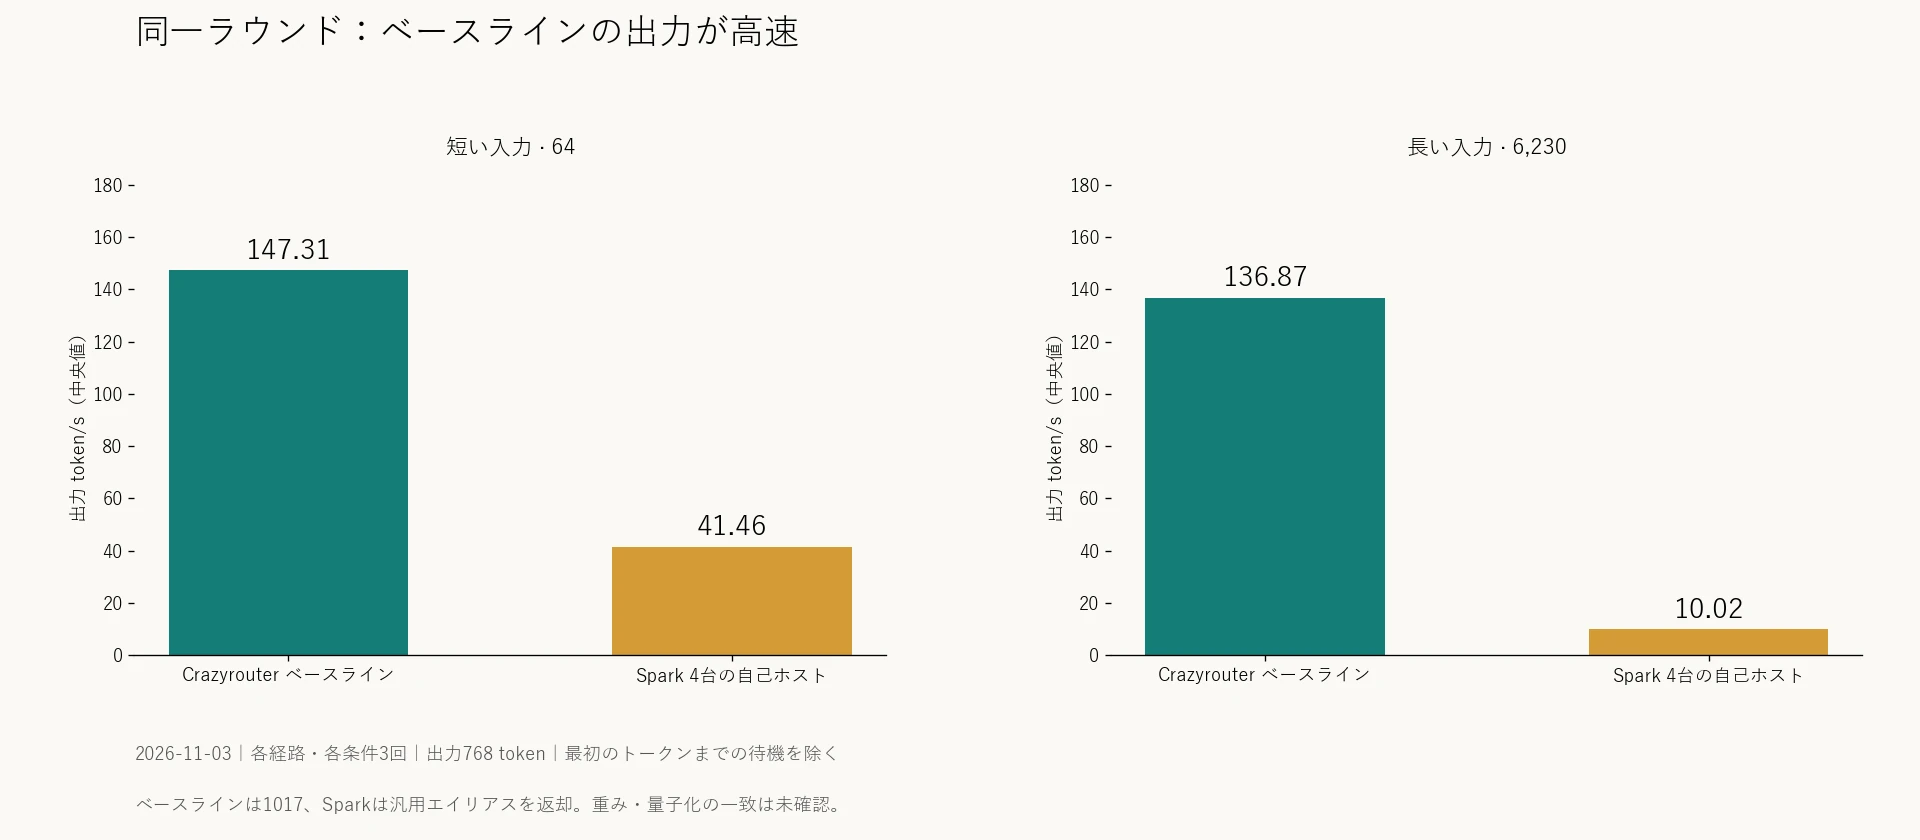
図1。2026年11月3日に、両側で各条件を3回ずつ測定。出力速度には最初の出力までの待ち時間を含めていません。両側の重みと量子化の同一性は未検証です。
短入力では、最初の出力までの待ち時間はSparkのほうがわずかに短かったものの、その後の生成が遅く、総所要時間は長くなりました。出力速度の中央値で比べると、ベースラインはSparkに対して短入力で約 3.55倍、長入力で約 13.66倍 でした。この倍率はその回のサービスの状態を示すもので、Spark 4台のハードウェア性能の上限を示すものではありません。
Sparkでは特に遅いリクエストも見られました。3回目の短入力は完了したものの、所要時間は約 105.38 秒、出力速度は約 7.47 token/s でした。そのため、エラーなく完了することと、対話時の応答が安定することは別々に評価する必要があります。参照用のほかの2チャネルでは、出力速度の中央値が短入力で143.69〜148.13 token/s、長入力で130.20〜141.49 token/sでした。この回のベースラインの速度は、4チャネルの中で突出した値ではありませんでした。1
キャッシュにヒットしても、なぜ速度は変動するのか?#
主テストで記録した長入力のキャッシュは以下のとおりです。
| サービス経路 | 長入力3回のキャッシュ済みトークン数 | 最後のリクエストでキャッシュ済みトークンが入力に占めた割合 |
|---|---|---|
| Crazyrouterベースライン | 0 → 6,144 → 6,144 | 98.62% |
| Spark 4台の自前運用 | 0 → 0 → 0 | 0% |
この回だけを見ると、Sparkがキャッシュに対応していないように見えます。しかし、11月4日01:04の再測定では長入力のキャッシュ済みトークン数が 0 → 6,234 → 6,234 となり、最後のリクエストでは入力の 99.98% を占めました。それでも、この回の長入力の出力速度の中央値は 13.37 token/s でした。3回の速度は順に13.37、12.90、45.15 token/sで、キャッシュにヒットした2件の間にも大きな速度差がありました。3
14:14の再測定では、最後の長入力でキャッシュ済みトークンの割合が 82.13% だった一方、出力速度の中央値は 57.91 token/s に達しました。キャッシュ済みトークンの割合だけでは、レスポンス全体の速さを説明できません。この割合は料金の削減率を表すものでもなく、今回のテストではこれをもとにコスト面の優位性を算出していません。
同じSpark環境でも、4つの時間帯で結果はどれほど違ったか?#
その後の再測定でも、同じタスク本文と出力パラメータを使いました。各回で異なるプレフィックスを付けたため、短入力は約64〜69 token、長入力は約6,230〜6,235 tokenとなり、リクエストはトークン単位で完全に一致していたわけではありません。
| テスト時刻 | 完了数 | 短入力の出力速度 | 長入力の出力速度 | 短入力での最初の出力までの待ち時間 | 長入力での最初の出力までの待ち時間 |
|---|---|---|---|---|---|
| 11月3日 23:43 | 6/6 | 41.46 token/s | 10.02 token/s | 3.25 秒 | 7.73 秒 |
| 11月4日 01:04 | 6/6 | 50.69 token/s | 13.37 token/s | 4.25 秒 | 3.61 秒 |
| 11月4日 14:14 | 6/6 | 56.70 token/s | 57.91 token/s | 2.04 秒 | 5.31 秒 |
| 11月4日 20:24 | 3/6 | 16.84 token/s* | 7.07 token/s* | 51.96 秒* | 37.59 秒* |
夜間の集計対象は完了したリクエストのみです。短入力は2/3件、長入力は1/3件が完了しました。中断した残り3件は、出力速度と最初の出力までの待ち時間の中央値に含めていません。
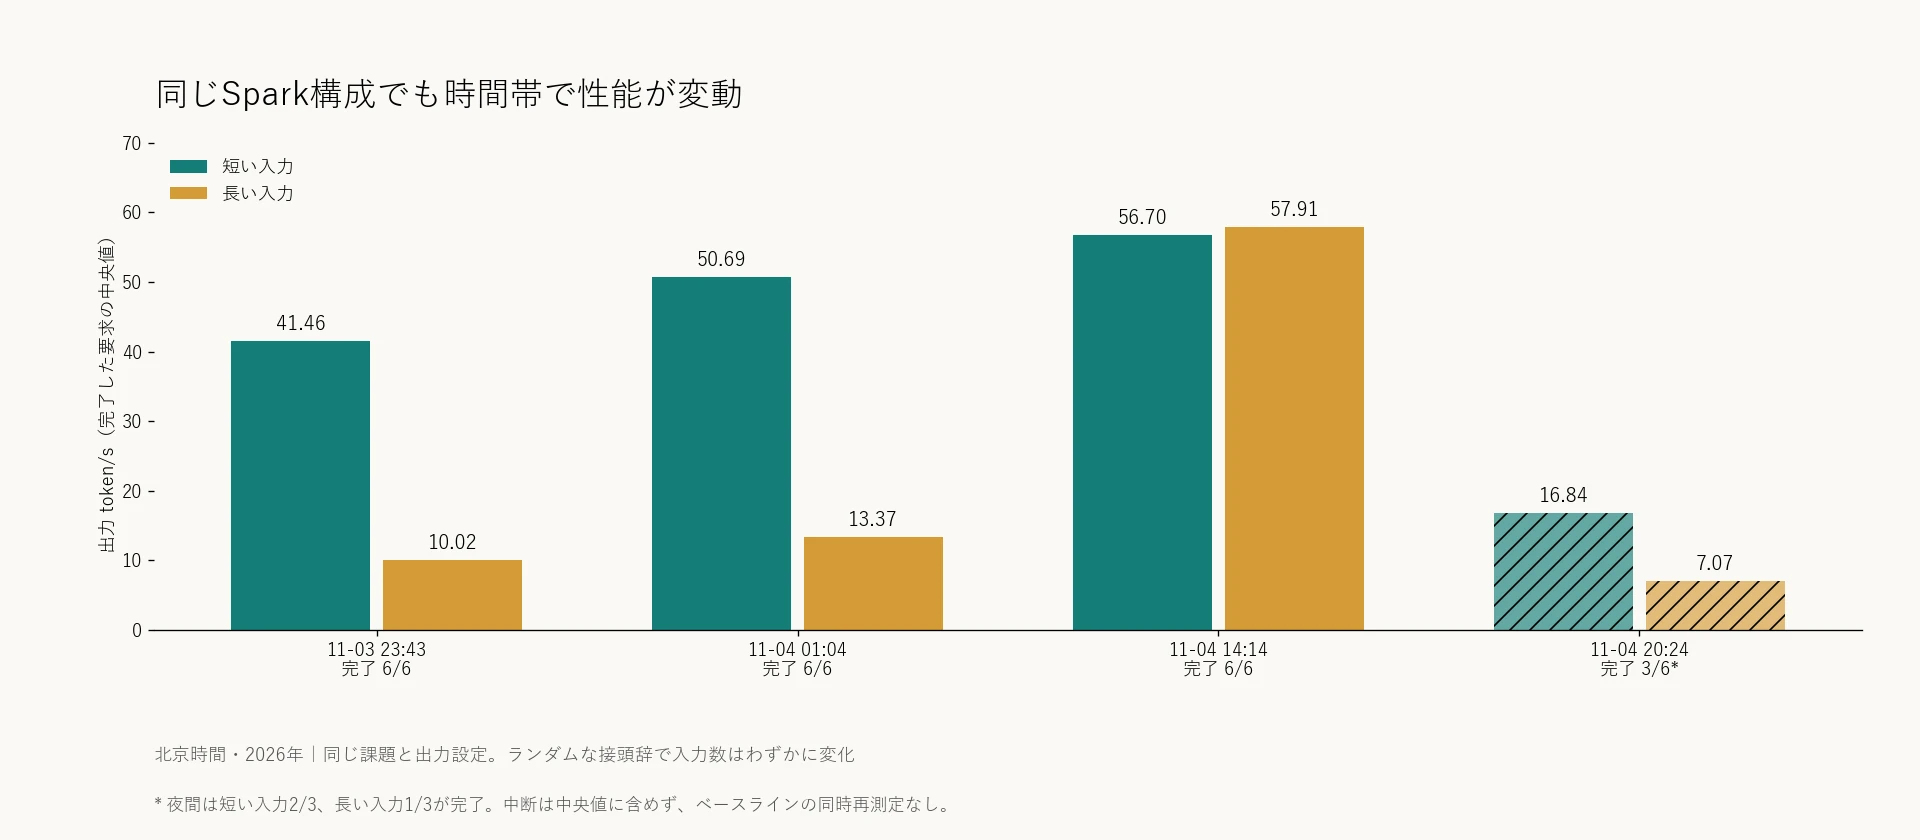
図2。後半の3回はSparkのみを再測定し、Crazyrouterベースラインの同時測定は行っていません。以前のベースラインと別の時間帯の測定値を組み合わせても、同じ回に条件をそろえた比較にはなりません。
夜間に中断した3件では、HTTP 200のレスポンスヘッダーとストリーミング出力の一部を受信しましたが、正常に完了しませんでした。クライアントは最終的に約 166〜187 秒 で呼び出しを終了し、サイト側のログには 499(クライアント切断) が記録されました。HTTP 200だけを数えると、この回の完了数を6/6と誤って記録することになります。3
夜間の結果では、完了したリクエストの速度低下に加え、6件中3件しか完了しなかった点が重要です。この少数のサンプルから長期の可用性を推定することはできません。
遅延はどこで生じたか? 当時の記録では負荷とキュー待ちが最も有力な説明#
当時の読み取り専用の確認では、4台のGB10ノードすべてで推論プロセスが動作していました。サービスの容量を記録したスナップショットでは slots=4、peak_batch=4 でした。この値が示すのは当時のエンジン設定であり、ソフトウェアやモデルを問わず適用できるSpark 4台の固定的な容量上限ではありません。
同じサービスの稼働中に、負荷の異なる2つの状況が記録されました。
- 11月4日19:44は比較的低負荷でした。 サーバー側のログでは、入力が32または59 token、出力が256 tokenのリクエストで 104.8〜156.8 token/s を記録し、最初の出力までは 0.115〜0.148 秒 でした。ログから再構成した時点で未完了だったリクエストは1件のみで、入力が10,000 tokenを超えるリクエストはありませんでした。
- 20:24に応答の遅かった回の測定が始まりました。 完了したリクエストの終了時刻と所要時間から逆算すると、入力が10,000 tokenを超えるリクエストが少なくとも 12件 残っており、その入力は合計で約 1,530,000 token でした。20:33の別のスナップショットでは、同様の未完了リクエストが少なくとも 16件 ありました。4
これらの件数は当時のログから逆算した下限で、待機中と実行中のリクエストの両方を含みます。12件または16件のリクエストがGPU上で同時にデコードされていたことを示すわけではありません。 ほかのトラフィックの発生元は、保存された資料からは特定できませんでした。
比較的低負荷のとき、Sparkは高速に出力できました。長いコンテキストを持つリクエストが多数残っている場合、クライアントに長時間出力が届かないことがあります。混雑時にはモデルへ直接接続したリクエストでも待ち時間が発生しており、遅延のすべてをCrazyrouterゲートウェイに帰することはできません。
記録から最も有力と考えられるのは、長いコンテキストによる負荷とキュー内での競合です。ただし、処理段階ごとのトレースがそろっていないため、遅延の内訳をスケジューラ、プリフィル、デコード、データ転送に正確に振り分けることはできません。19:44の速度は、短いプロンプトと256 tokenの出力を条件にサーバー側で観測した値です。クライアント側で768 tokenの出力を測った主テストとは、同じ集計に含められません。
Crazyrouterゲートウェイは遅延を増やすか? 追加測定の2組では増加#
11月4日22:16には、比較的低負荷の状態で2組のペア測定を追加しました。各組では、インターネット経由で直接接続する経路とCrazyrouterの転送を経由する経路から、同じSparkの自前運用サービス に同時にリクエストを送信しました。入力は両経路とも同じ26 tokenで、出力上限は256 tokenでした。
| ペア | 経路 | 最初の出力までの待ち時間 | 総所要時間 |
|---|---|---|---|
| 1 | Sparkに直接接続 | 0.786 秒 | 3.779 秒 |
| 1 | Crazyrouter経由で同じSparkに接続 | 6.150 秒 | 8.307 秒 |
| 2 | Sparkに直接接続 | 1.031 秒 | 4.301 秒 |
| 2 | Crazyrouter経由で同じSparkに接続 | 3.704 秒 | 7.496 秒 |
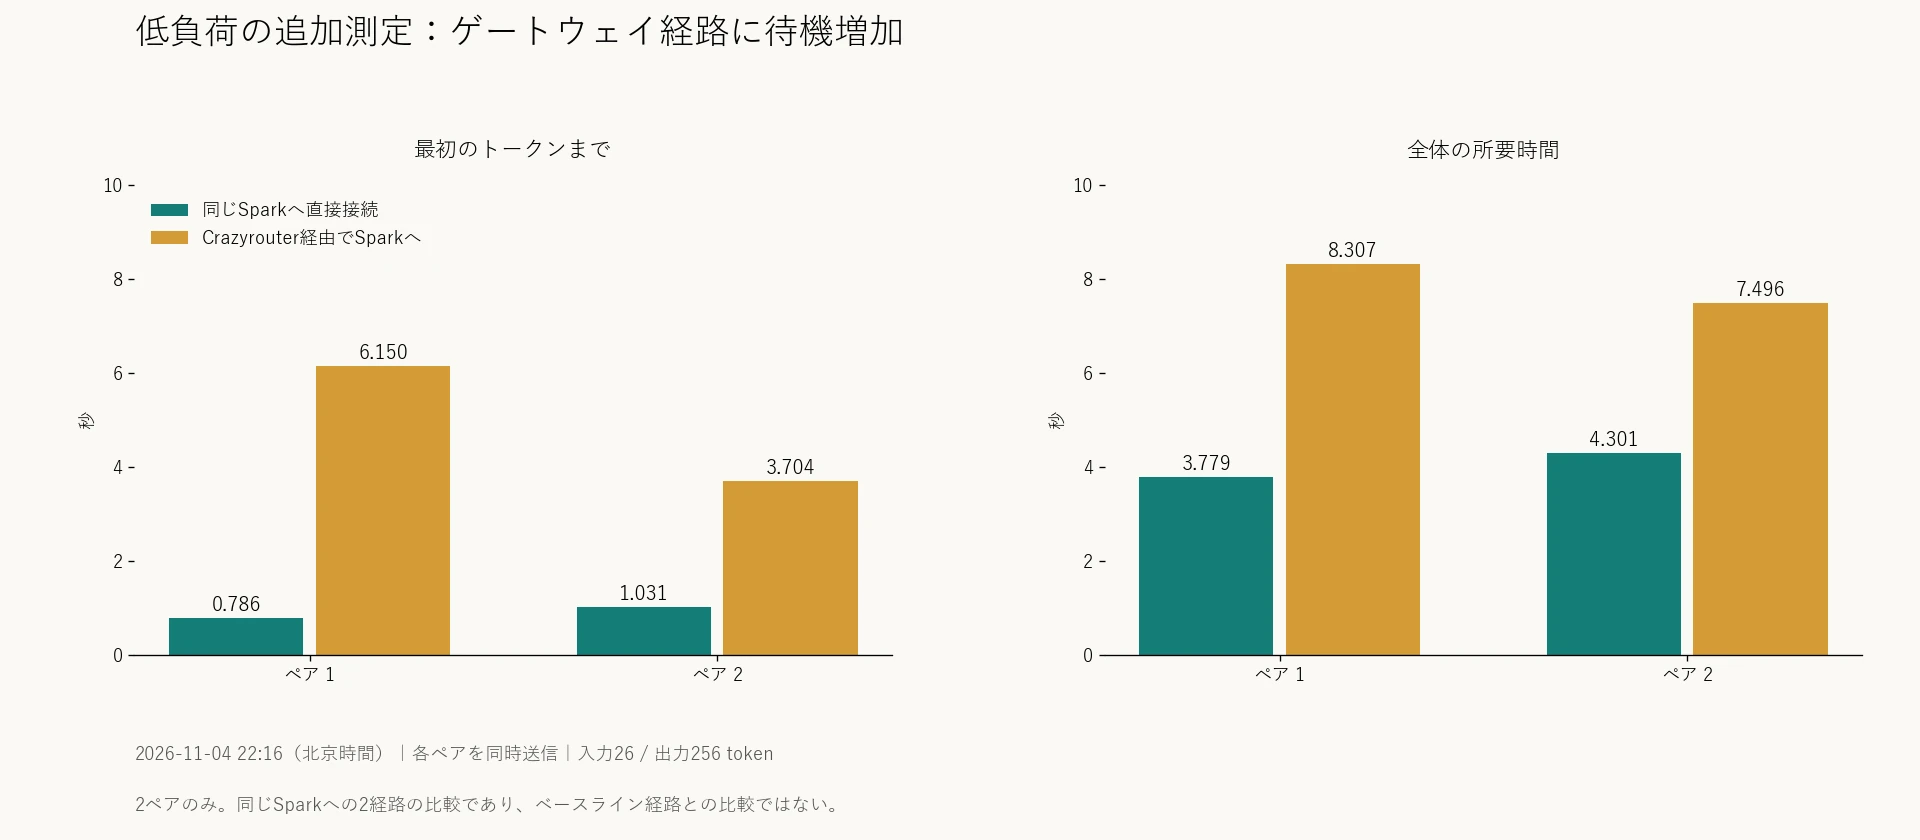
図3。ここでの比較対象は、同じSparkサービスへの2つのアクセス経路です。前述の1017ベースラインはこの比較に含まれません。各組のリクエストは同時に送信しましたが、推論サービスへの到着が同時だったとは限りません。
ゲートウェイ経由の総所要時間は、それぞれ 4.528 秒、3.195 秒 長くなりました。サーバー側で記録した処理時間は近い値だったため、この差には、リクエストが推論サービスに到着する前の追加の待ち時間が含まれていると考えられます。ただし、2組のサンプルだけでは、ゲートウェイでの処理、外向きの接続、外部公開用のマッピングがそれぞれどれだけ寄与したかを切り分けられません。この差をゲートウェイの固定的なオーバーヘッドとみなすこともできません。5
より速い上流サービスを選ぶことと、同じ自前運用のバックエンドに転送経路を追加することは、別の検討事項です。 先の同時測定ではベースラインのほうが速く、今回の2組の追加測定では、Sparkに直接接続した場合のエンドツーエンドの所要時間が短くなりました。
自前運用を検討する際、この結果をどう活用すべきか?#
今回の記録では、Spark 4台でこのDeepSeekサービスを稼働させられることを確認できました。応答時間を予測できるサービスにするには、低負荷時に1回測るだけでは受け入れ検証として不十分です。
デプロイを予定しているチームには、次回の受け入れ検証で次の4点を確認することを勧めます。
- 最初にバージョンを固定する。 重みのリビジョン、ハッシュ、量子化、推論エンジンのバージョンとトポロジーを記録します。APIのエイリアスだけで完全に同じモデルだと判断することを避けられます。
- 実際の業務を想定した混合負荷でテストする。 短い対話、約6Kのコンテキスト、実運用で発生する長いリクエストを同時に流し、短いリクエストが遅くなるかを確認します。
- 待ち時間、出力速度、完了率をあわせて記録する。 中断したサンプルもすべて残し、十分なサンプルを集めてからP95/P99を集計します。最速の出力だけでは、こうした分布は把握できません。
- サーバー側とクライアント側の計測を突き合わせる。 直接接続とゲートウェイ経由、アイドル時と混雑時をそれぞれ比較し、次にどの区間を最適化すべきかを判断します。
本記事のテスト条件で応答速度を優先する場合、同じ回の結果ではCrazyrouterベースラインが有利でした。デプロイ環境やスケジューリング方針を自ら管理したい場合、今回のSparkの記録は受け入れ検証の参考になります。自前運用を採用するか判断するには、処理容量、品質、障害からの復旧、運用保守コストに関するデータも必要です。
4台の機器の購入費やレンタル料、電気料金、消費電力、稼働率、保守工数は測定しておらず、回答品質の採点も行っていません。本記事の結果から、自前運用のほうが安いことや、どちらかのモデルのほうが賢いことは証明できません。
よくある質問#
NVIDIA Spark 4台でDeepSeek V4.1 Flash 1017を自前運用すれば、APIを置き換えられますか?#
今回の記録から、4台のGB10ノード上のサービスがDeepSeekへのリクエストに応答できることは確認できました。ただし、自前運用側の重みが同じ1017リビジョンかどうかは確認できていません。業務で使っているAPIを置き換えられるかは、実際の負荷、応答の制限時間、品質、運用保守の要件によります。夜間の完了数が3/6だったことから、混雑時の受け入れ検証も必要です。
主テストで見られた13.66倍の差は、ハードウェア性能の差ですか?#
この値は、同じ回で測定した長入力の出力速度の中央値同士の比です。当時のキャッシュ、負荷、推論サービス、アクセス経路などの違いを含むため、GPUの演算性能の倍率は推定できません。
キャッシュヒット率が99.98%なのに、なぜ十分に速くならなかったのですか?#
この回では入力のほぼすべてがキャッシュにヒットしましたが、長入力の出力速度の中央値は13.37 token/sでした。キャッシュヒットの割合だけでは処理全体の速さを把握できません。当時の記録には処理段階ごとの計測が十分に残っておらず、各要因の影響は定量化できません。
Sparkは毎秒100 tokenを超える速度を出せますか?#
過去のサーバー側ログでは、比較的低負荷で、短入力と256 tokenの出力という条件で、104.8〜156.8 token/sを記録しています。クライアント側で768 tokenの出力を測った主テストとは計測方法が異なります。この数値を、負荷にかかわらず持続できる性能として示すことはできません。
HTTP 200が返れば、呼び出しは成功と数えられますか?#
今回の夜間テストでは、HTTP 200と出力の一部を受信した3件が、正常に終了する前に中断しました。このため、完了数は6/6ではなく3/6と集計しました。
自前運用とCrazyrouterでは、どちらが安いですか?#
本記事には、同じ条件で比較できる十分なコストデータがないため、結論は出せません。コストを試算するには、機器費用、稼働率、運用保守費、失敗時の再試行コストを、同じ業務量での実際のAPI請求額と比較する必要があります。最新の料金はCrazyrouterの料金ページで確認できます。現在の料金を過去のテストで実際に発生した費用として扱うことはできません。Crazyrouterの料金ページ
テスト資料と参考情報#
アプリケーションへの組み込みについては、Crazyrouterの連携ガイドを参照できます。Crazyrouterの連携ガイド タスクの正答率や実際に発生した費用を比較したい場合は、別の独立したテスト「GPT-6.2 SolとDeepSeek V4.1 Flashのクラウド比較」を参照してください。設問と採点方法が本記事の速度測定とは異なるため、結果を統合することはできません。GPT-6.2 SolとDeepSeek V4.1 Flashのクラウド比較 (中国語)
本記事はCrazyrouterの過去のテストアーカイブをもとにまとめたものです。統計は2026年11月20日に再集計しました。元のサンプル、チャネルの確認記録、機器診断のインデックスは社内アーカイブに保存しています。以下の注では、各データの出典と集計範囲を示します。
著者:Sophie M · 記事整理日:2026年11月20日 · データ取得日:2026年11月3〜4日。
Footnotes#
-
2026年11月3日の4チャネルでの主テスト。本測定のリクエストは26件で、本記事ではベースラインとSparkから各6件を取り上げた。リクエスト単位の記録、集計結果、利用ログを相互に照合した。 ↩ ↩2 ↩3
-
主テストのレスポンス内のモデルフィールドと、2026年11月4日の4ノードの機器確認。確認できたのはレスポンス識別子とデプロイ先のプロセスのみで、重みの同一性は検証していない。 ↩
-
2026年11月4日01:04、14:14、20:24に行ったSparkの再測定3回。各回6件で、夜間にクライアント側で中断した3件も別途記録した。 ↩ ↩2
-
2026年11月4日の機器診断記録。未完了リクエスト数は完了済みリクエストの所要時間から逆算し、待機中と実行中の両方を含む。 ↩
-
2026年11月4日22:16に追加した、直接接続とゲートウェイ経由のペア測定。計2組のリクエストで、入力は26 token、出力は256 token。 ↩
Implementation Guides
最新エピソード
EP196 · 2026年10月29日 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 2026年10月28日 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.