简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
4 台 NVIDIA Spark 自行部署 DeepSeek 實測:與 Crazyrouter V4.1 Flash 1017 基準比較
根據 2026 年 11 月 3—4 日的歷史實測,比較四台 NVIDIA Spark 自行部署的 DeepSeek 與 Crazyrouter V4.1 Flash 1017 基準,分析長短輸入的輸出速度、快取、晚間請求中斷,以及直連與閘道延遲。尚未驗證兩側權重版本是否相同。
在四台 NVIDIA Spark 上自行部署 DeepSeek,實際呼叫表現能接近現成的 API 嗎?我們回顧了 2026 年 11 月 3—4 日的測試。同一輪測試中,Crazyrouter 基準服務的輸出較快。後續測試中,Spark 的表現隨時段明顯變化,低負載和繁忙時段的使用體驗差距很大。
在 11 月 3 日的同輪小樣本測試中,Crazyrouter DeepSeek V4.1 Flash 1017 基準服務在短、長輸入下的輸出速度中位數分別為 147.31、136.87 token/s,四台 Spark 自行部署的服務則分別為 41.46、10.02 token/s。兩側均完成 6/6 次測速請求。1
本文探討部署後的實際呼叫表現,包括首字等待時間、串流輸出速度、重複的上下文能否命中快取,以及繁忙時段能否在測試時限內完成請求。**資料來自歷史存檔,11 月 20 日並未重跑測試,這些結果也不代表目前的服務狀態。**下文時間均為北京時間。
先確認版本:1017 基準與 Spark 自行部署的版本相同嗎?#
本文涉及的模型系列與 Spark 產品背景,可分別參考 Crazyrouter DeepSeek 模型頁面 (英文)及 NVIDIA DGX Spark 官方頁面。這些頁面供延伸閱讀,歷史效能結論以本文的測試存檔為準。
當時兩側請求指定的模型名稱都是 deepseek-v4.1-flash,但回應中的模型欄位並不完全相同。
| 比較對象 | 回應中的模型名稱 | 當時可確認的範圍 |
|---|---|---|
| Crazyrouter 基準 DeepSeek | deepseek-v4.1-flash-1017 | 回應識別碼帶有 1017 後綴 |
| 四台 Spark 自行部署的 DeepSeek | deepseek-v4.1-flash | 經檢查確認,四個 GB10 節點都在執行推論 rank 程序 |
歷史資料未完整記錄自行部署端的權重雜湊值、確切修訂版本及量化設定。因此,本文的 DeepSeek V4.1 Flash 1017 僅指基準服務回應中的識別碼。兩側權重是否相同,尚未驗證,單憑回應中的模型名稱也無法獨立驗證權重。2
搜尋「NVIDIA Spark deepseekv4.1flash1017 自行部署」時,確認部署服務提供相容介面,以及證明它執行的是完全相同的模型版本,需要分別驗證。 本文比較的是當時兩條實際的服務路徑,並未控制所有變因,無法據此排列 GPU 硬體的效能名次。
測試方法:相同入口、固定渠道、固定輸出預算#
11 月 3 日的主測試透過同一個 Crazyrouter 入口呼叫兩條固定渠道,一條通往基準服務,另一條通往四台 Spark 自行部署的服務。測試未混入其他渠道的回應,過程中也沒有修改渠道設定。
歷史測試實際使用的網址如下。
Base URL: https://crazyrouter.com/v1
Endpoint: POST /chat/completions
Model: deepseek-v4.1-flash
下方摘錄測量使用的核心參數。完整請求也包含相同的任務正文,以及用來區分輪次的前綴。
{
  "model": "deepseek-v4.1-flash",
  "stream": true,
  "temperature": 0,
  "max_tokens": 768,
  "thinking": { "type": "disabled" }
}
短輸入為 64 token,長輸入為 6,230 token,各測試三次。長輸入沿用相同正文,以觀察快取情形。前一次請求結束後,間隔六秒再送出下一次請求。不同渠道平行測試,同一渠道內則依序送出請求。
整輪歷史測試涵蓋四條渠道,共 26 次正式請求。本文聚焦基準服務與 Spark 的 12 次請求。另兩條渠道用來核對結果範圍,另外一次獨立的冒煙測試不列入統計。所有正式請求都已與用量紀錄核對渠道和 token 數。
主測試的每次請求都輸出 768 token,推理 token 數為零。這裡的「完成」指用戶端收到完整的串流結束訊號和用量紀錄。達到輸出預算時以 finish_reason=length 結束,符合本次測速設計。6/6 完成只代表固定輸出測速請求的傳輸完整結束,無法用來判斷答題正確率,也無法確認模型是否自然完成業務任務。
我們分別統計兩項時間指標。首字等待時間從用戶端送出請求時開始計算。輸出速度則以輸出 token 數除以首個正文區塊至最後一個正文區塊之間的時間。輸出速度是用戶端的估計值,計入首個區塊的 token,並排除先前的連線及排隊時間。表格均採三次請求的中位數。1
同輪結果:短輸入的首字等待相近,持續輸出速度差距明顯#
| 指標 | Crazyrouter 1017 基準 | 四台 Spark 自行部署 |
|---|---|---|
| 完成請求數 | 6/6 | 6/6 |
| 短輸入首字等待時間中位數 | 3.31 秒 | 3.25 秒 |
| 短輸入輸出速度中位數 | 147.31 token/s | 41.46 token/s |
| 短輸入總耗時中位數 | 9.05 秒 | 21.78 秒 |
| 長輸入首字等待時間中位數 | 3.36 秒 | 7.73 秒 |
| 長輸入輸出速度中位數 | 136.87 token/s | 10.02 token/s |
| 長輸入總耗時中位數 | 9.09 秒 | 84.40 秒 |
| 最慢單次請求總耗時 | 10.26 秒 | 156.11 秒 |
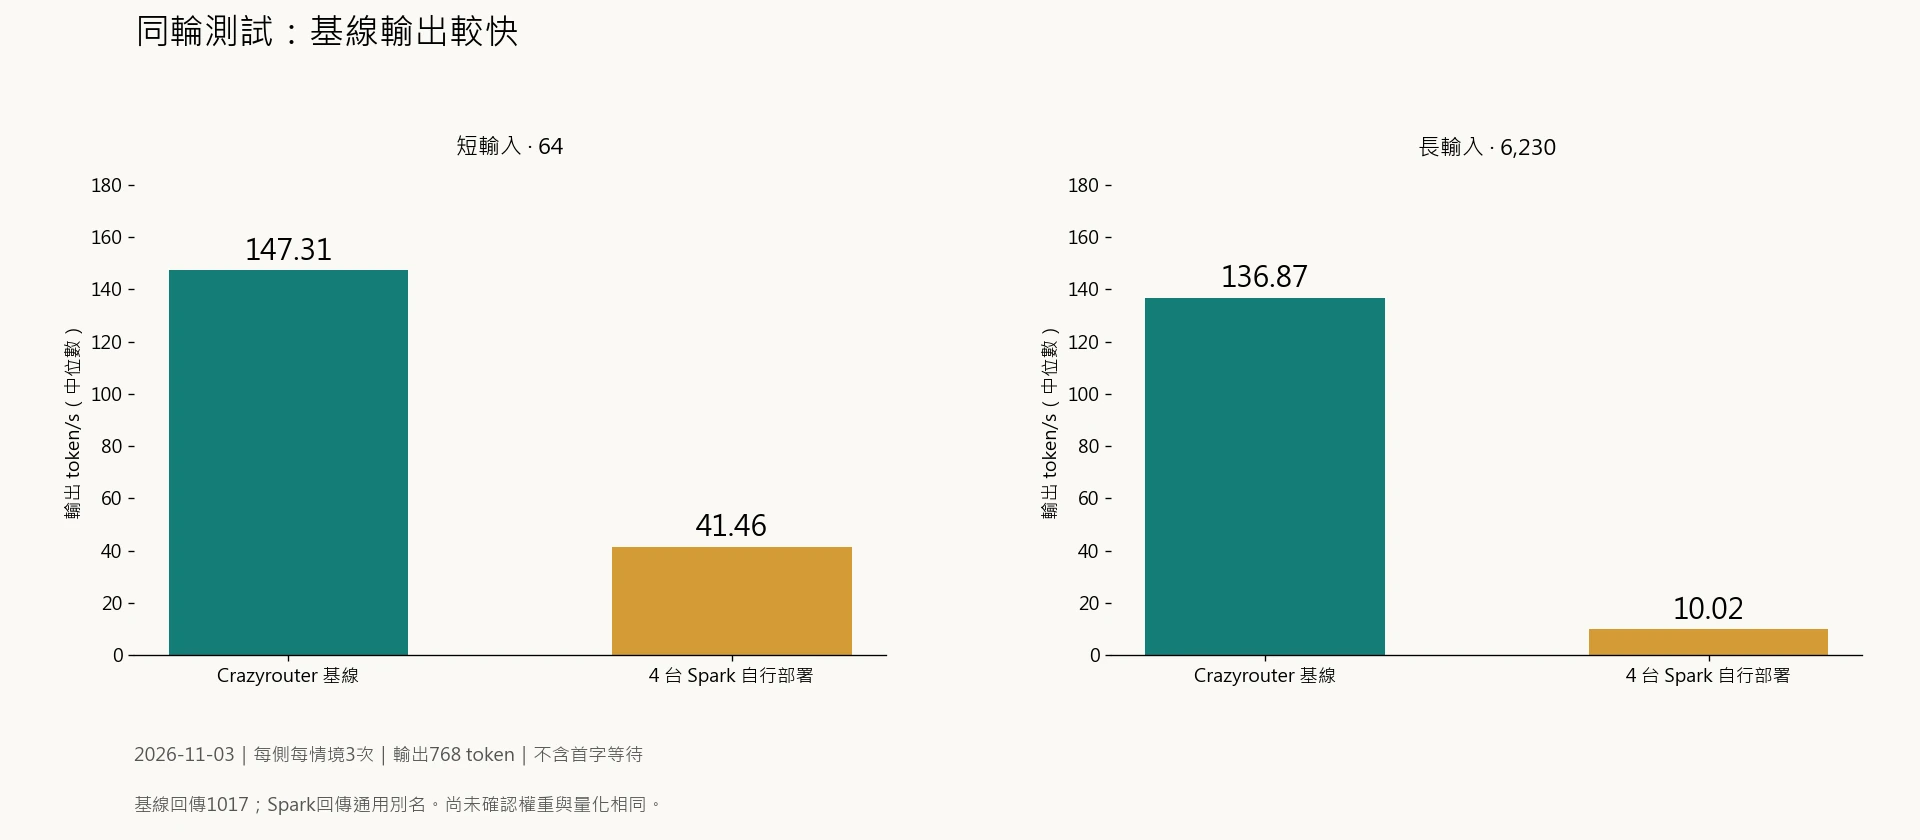
圖 1 2026 年 11 月 3 日,兩側在每種輸入情境下各測三次。輸出速度不含首字等待時間。兩側的權重與量化設定是否相同,尚未驗證。
在短輸入情境中,Spark 的首字等待時間甚至略短,但後續生成較慢,總耗時也更長。以輸出速度中位數計算,基準服務在短輸入下約為 Spark 的 3.55 倍,長輸入下約為 13.66 倍。這些倍數只反映當輪的服務狀態,無法據此推算四台 Spark 的硬體效能上限。
Spark 也出現明顯較慢的請求。第三次短輸入約耗時 105.38 秒,輸出速度約 7.47 token/s,最後仍完整結束。因此,請求是否報錯與互動體驗是否穩定,需要分開評估。另外兩條參考渠道的短輸入輸出速度中位數為 143.69—148.13 token/s,長輸入為 130.20—141.49 token/s。基準服務在這一輪的速度落在這兩條參考渠道的範圍內。1
快取能命中,為什麼速度仍會波動?#
主測試的長輸入快取紀錄如下。
| 服務路徑 | 三次長輸入的快取 token 數 | 最後一次快取占輸入比例 |
|---|---|---|
| Crazyrouter 基準 | 0 → 6,144 → 6,144 | 98.62% |
| 四台 Spark 自行部署 | 0 → 0 → 0 | 0% |
單看這一輪,容易以為 Spark 不支援快取。後續紀錄顯示,11 月 4 日 01:04 的複測中,長輸入的快取 token 數為 0 → 6,234 → 6,234,最後一次占輸入的 99.98%。這一輪長輸入的輸出速度中位數仍只有 13.37 token/s,三次分別為 13.37、12.90、45.15 token/s,其中兩次命中快取的請求,輸出速度仍有明顯差異。3
14:14 複測時,最後一次長輸入的快取比例為 82.13%,輸出速度中位數卻達到 57.91 token/s。這些紀錄顯示,單看快取 token 的占比,無法解釋整段回應的快慢。這個比例也無法直接換算成費用節省百分比,本次測試未據此計算成本優勢。
同一套 Spark,四個時段的結果相差多少?#
後續複測沿用相同的任務正文和輸出參數。每輪都使用不同的前綴,因此短輸入約為 64—69 token,長輸入約為 6,230—6,235 token,各輪請求的 token 並不完全相同。
| 測試時間 | 完成數 | 短輸入輸出速度 | 長輸入輸出速度 | 短輸入首字等待時間 | 長輸入首字等待時間 |
|---|---|---|---|---|---|
| 11 月 3 日 23:43 | 6/6 | 41.46 token/s | 10.02 token/s | 3.25 秒 | 7.73 秒 |
| 11 月 4 日 01:04 | 6/6 | 50.69 token/s | 13.37 token/s | 4.25 秒 | 3.61 秒 |
| 11 月 4 日 14:14 | 6/6 | 56.70 token/s | 57.91 token/s | 2.04 秒 | 5.31 秒 |
| 11 月 4 日 20:24 | 3/6 | 16.84 token/s* | 7.07 token/s* | 51.96 秒* | 37.59 秒* |
晚間的速度與首字等待時間中位數僅納入已完成的請求。短輸入完成 2/3,長輸入完成 1/3,其餘三個中斷的請求不列入中位數。
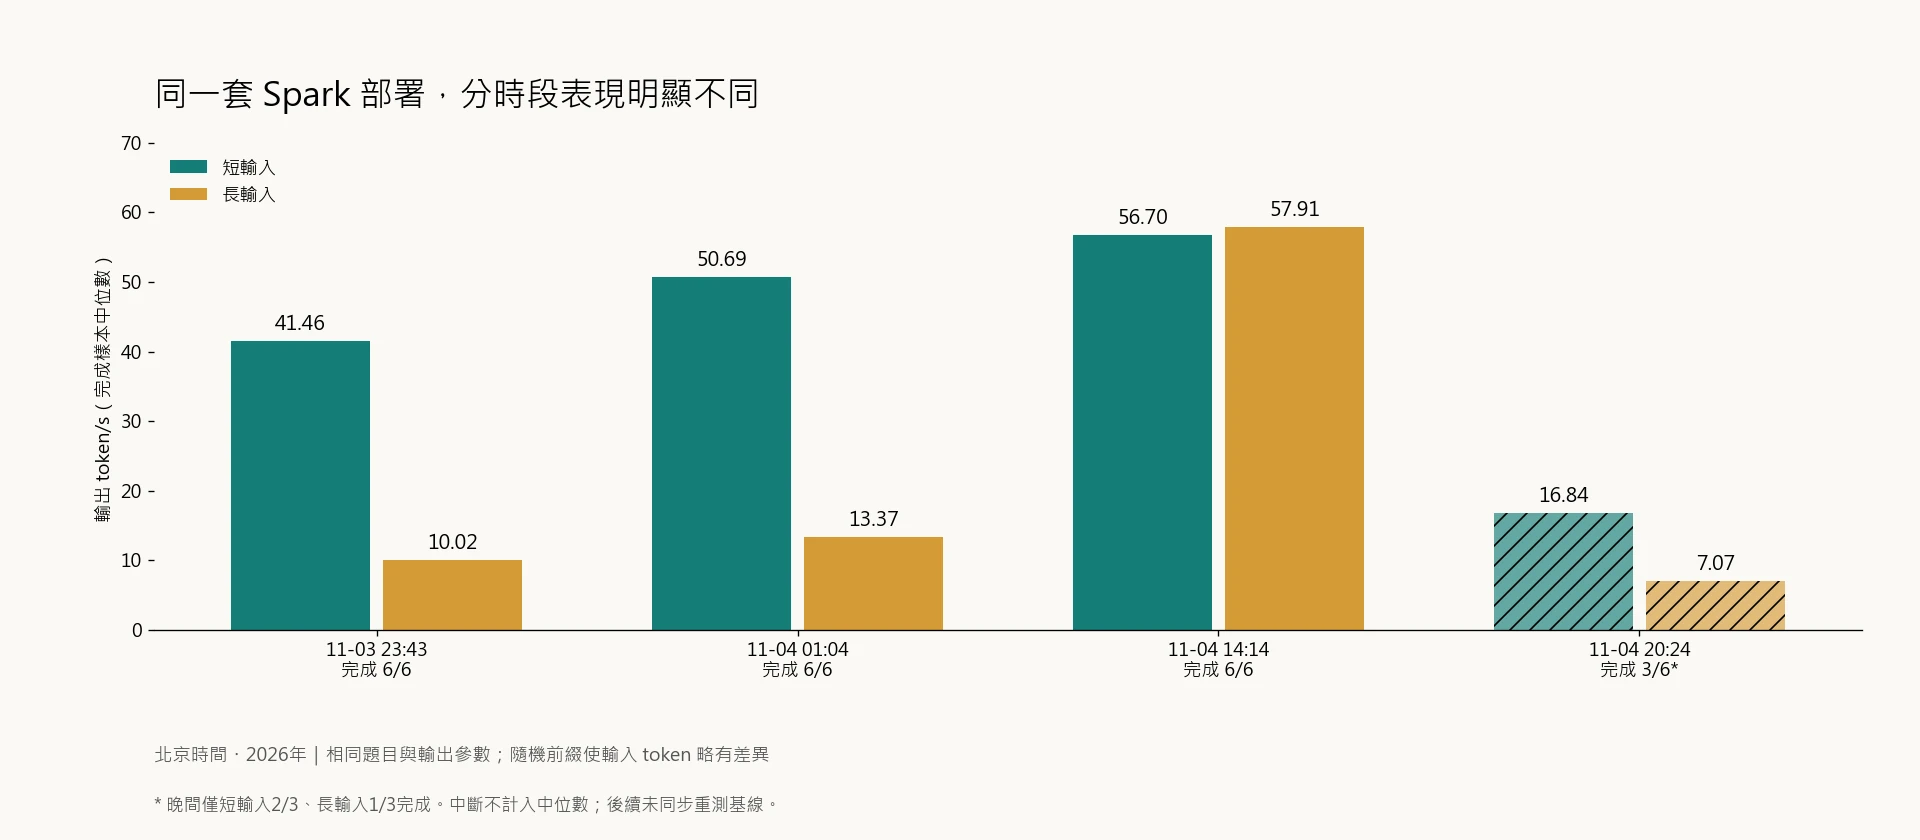
圖 2 後三輪只複測 Spark,未同步重跑 Crazyrouter 基準測試。先前的基準結果與後續時段的結果不能視為同一輪受控比較。
晚間中斷的三個請求都曾收到 HTTP 200 回應標頭與部分串流內容,但未正常完成。用戶端在約 166—187 秒後結束呼叫,站點日誌記錄為 499 用戶端中斷連線。如果只計算 HTTP 200 回應,就會把這一輪誤記為 6/6 完成。3
晚間除了已完成請求的速度變慢,六次請求也只完成三次。這輪樣本數太少,無法據此估計長期可用率。
延遲出在哪裡?當時的紀錄指向負載與排隊#
當時的唯讀檢查確認,四個 GB10 節點都在執行推論程序。服務的容量快照顯示 slots=4、peak_batch=4。這是當時的推論引擎設定,四台 Spark 的容量上限會隨軟體與模型而異,不能由此推定。
同一個運作中的服務,在不同負載下留下兩組紀錄。
- 11 月 4 日 19:44,負載較輕。 伺服器端日誌顯示,輸入為 32 或 59 token、輸出為 256 token 的請求,輸出速度達 104.8—156.8 token/s,首字等待時間為 0.115—0.148 秒。依紀錄回推,當時只有一個尚未完成的請求,沒有輸入超過 10,000 token 的長請求。
- 20:24,出現延遲的測試開始。 依已完成請求的結束時間與持續時間回推,至少有 12 個輸入超過 10,000 token 的請求尚未結束,輸入合計約 1,530,000 token。到 20:33,另一份快照顯示至少有 16 個這類尚未完成的請求。4
這些數字是從歷史日誌回推的下限,同時包含等待中與執行中的請求,無法據此判定當時有 12 或 16 個請求同時在 GPU 上解碼。 存檔並未查明其他流量的來源。
負載較輕時,Spark 可以快速生成內容。大量長上下文請求尚未結束時,用戶端可能要等很久才收到內容。繁忙時段直接呼叫模型也出現等待,因此無法把所有延遲都歸因於 Crazyrouter 閘道。
現有紀錄最支持長上下文負載與排隊競爭是延遲原因。由於缺乏完整的逐階段追蹤,無法精確判定多少延遲分別來自排程器、預填充、解碼或傳輸。19:44 的速度是以伺服器端日誌觀測短提示詞、輸出 256 token 的請求所得,不能與前面由用戶端測量、輸出 768 token 的主測試合併計算。
Crazyrouter 閘道會增加延遲嗎?兩組補測都觀察到額外延遲#
11 月 4 日 22:16,測試在較低負載下進行了兩組配對請求。每組同時透過公網直連路徑及 Crazyrouter 轉送路徑,呼叫同一套 Spark 自行部署服務。輸入相同,為 26 token,輸出預算為 256 token。
| 配對 | 路徑 | 首字等待時間 | 總耗時 |
|---|---|---|---|
| 1 | 直連 Spark | 0.786 秒 | 3.779 秒 |
| 1 | 經 Crazyrouter 轉送至同一套 Spark | 6.150 秒 | 8.307 秒 |
| 2 | 直連 Spark | 1.031 秒 | 4.301 秒 |
| 2 | 經 Crazyrouter 轉送至同一套 Spark | 3.704 秒 | 7.496 秒 |
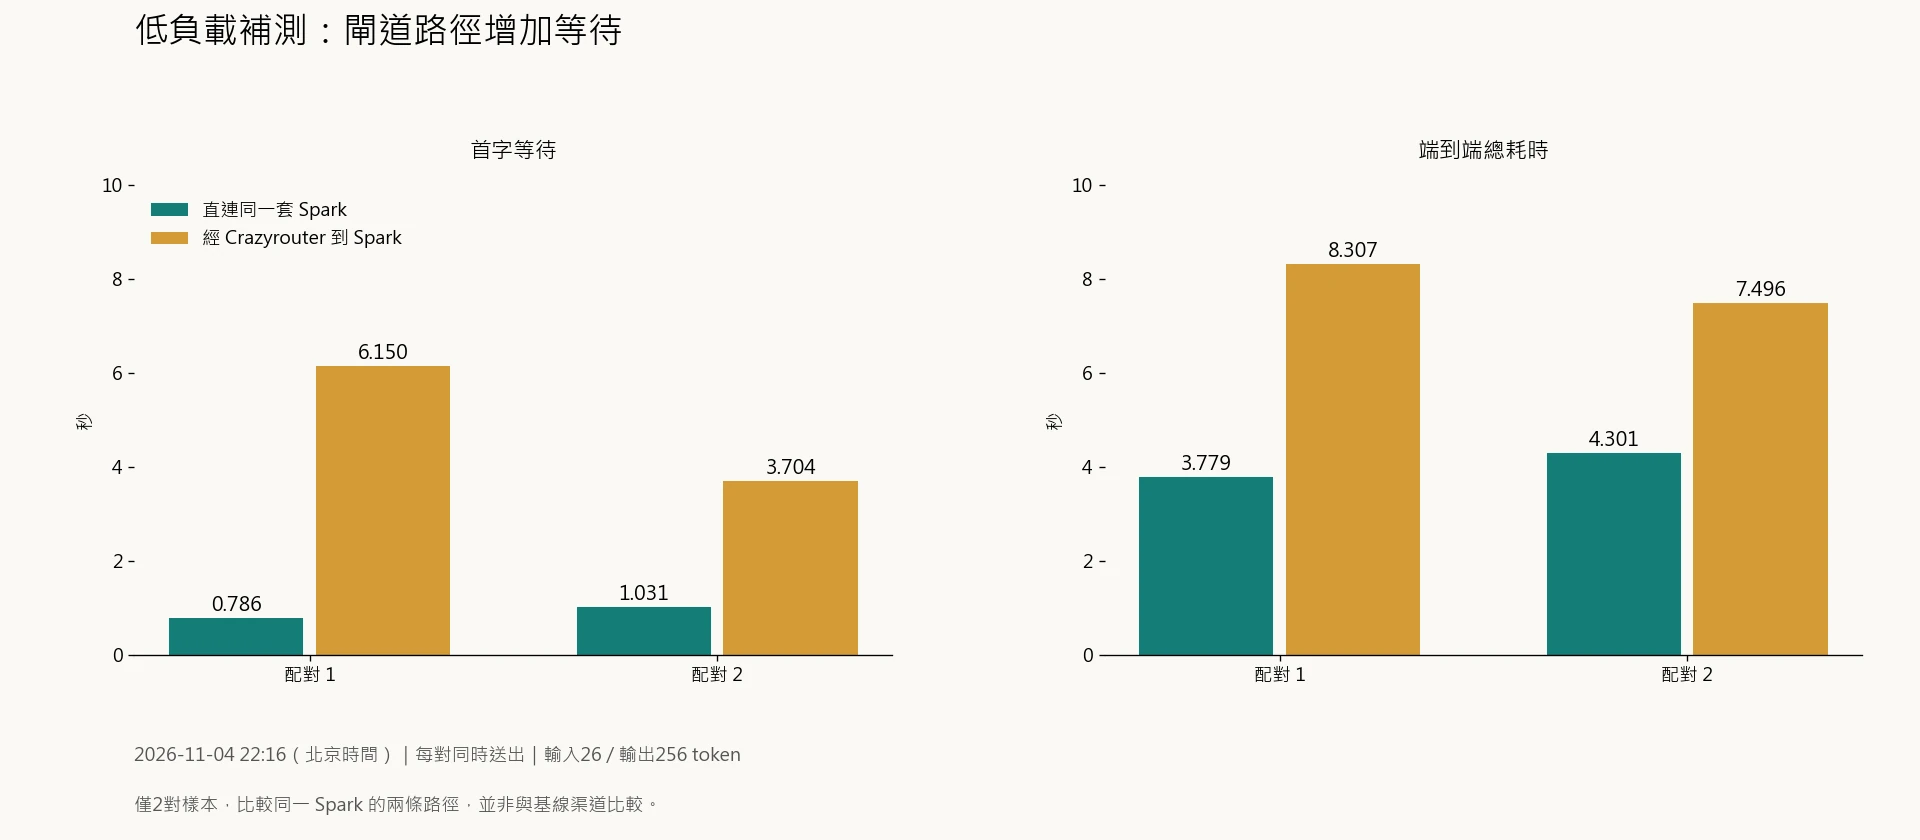
圖 3 這裡比較的是通往同一套 Spark 服務的兩種路徑,前文的 1017 基準服務未參與。每組請求同時送出,但抵達推論服務的時間可能不同。
經閘道的總耗時分別多出 4.528 秒、3.195 秒。伺服器端記錄的處理時間較為接近,顯示部分額外等待可能發生在請求抵達推論服務之前。僅憑兩組樣本,無法判定閘道處理、對外連線與公網映射各占多少時間,也無法把觀察到的差值視為固定的閘道開銷。5
選擇速度更快的上游服務,以及為同一個自行部署的後端加上一層轉送,需要分別評估。 前面的同輪測試中,基準服務較快。這兩組補測中,直連 Spark 的端對端耗時則較短。
如果準備自行部署,該如何運用這組結果?#
這次紀錄顯示,四台 Spark 可以執行這套 DeepSeek 服務。若要提供可預期的呼叫體驗,驗收還需涵蓋低負載單次測速以外的情境。
準備部署的團隊,可在下一輪驗收中完成以下四項工作。
- 先固定版本。 記錄權重修訂版本、雜湊值、量化設定、推論引擎版本與拓樸,以便獨立於介面別名驗證版本是否相同。
- 依實際業務情境測試混合負載。 同時測試短對話、約 6K 的上下文,以及實際會遇到的長請求,觀察短請求是否受到拖累。
- 同時記錄等待時間、速度與完成率。 完整保留中斷樣本,待樣本數充足後統計 P95/P99,讓評估涵蓋最快一次輸出以外的情況。
- 對齊伺服器端與用戶端的計時。 分別比較直連與閘道路徑,以及閒置與繁忙狀態,找出接下來應優化的環節。
如果業務優先考量本文測試條件下的回應速度,Crazyrouter 基準服務在同輪測試中較有優勢。如果業務目標是掌握部署環境與排程策略,這組 Spark 紀錄可以作為驗收依據。是否採用自行部署,還需要補齊容量、品質、故障復原與維運成本資料。
我們未測量四台機器的採購或租賃費用、電費、功率、使用率及維護工時,也未對回答品質評分。本文無法證明自行部署比較省錢,也無法證明任一側的模型比較聰明。
常見問題#
用四台 NVIDIA Spark 自行部署 DeepSeek V4.1 Flash 1017,能取代 API 嗎?#
這批紀錄可以確認,在四個 GB10 節點上執行的服務能回應 DeepSeek 請求,但無法確認自行部署的權重是否為同一個 1017 修訂版本。能否取代業務使用的 API,仍取決於實際負載、回應時限、品質和維運需求。晚間只有 3/6 完成,顯示仍需補做繁忙時段的驗收。
主測試的 13.66 倍差距,是硬體效能差距嗎?#
無法這樣推論。這是同一輪長輸入測試中,兩側輸出速度中位數的比值,反映了當時的快取、負載、推論服務和存取路徑等差異,無法據此推算 GPU 算力的倍數差距。
快取命中 99.98%,為什麼還不夠快?#
該輪快取幾乎完全命中,長輸入的輸出速度中位數仍只有 13.37 token/s。單看快取命中比例,無法判斷整體速度。歷史紀錄也缺少各階段的完整計時,無法進一步量化各項原因的影響。
Spark 能跑到每秒一百多個 token 嗎?#
歷史伺服器端日誌在低負載、短輸入、輸出 256 token 的條件下,記錄到 104.8—156.8 token/s。這與以用戶端測量、輸出 768 token 的主測試採用不同的測量方式,無法據此承諾在任何負載下都能維持這個速度。
收到 HTTP 200 就算成功呼叫一次嗎?#
本次晚間測試中,有三個請求收到 HTTP 200 和部分內容後中斷,未完整結束,因此完成數為 3/6。單憑 HTTP 200 會誤計為 6/6。
自行部署和 Crazyrouter,哪個比較便宜?#
本文缺少依相同方式計算的完整成本資料,無法得出結論。若要估算成本,應以相同業務量比較硬體成本、使用率、維運及失敗後重試的成本與 API 實際帳單。即時費率可在 Crazyrouter 價格頁面查詢,而歷史測試的實際成本仍須以當時的帳單為準。
測試資料與延伸閱讀#
後續如需將 API 整合至應用程式,可參考 Crazyrouter 整合指南 (英文)。若想了解任務正確率與實際費用的比較,可閱讀另一項獨立測試 GPT-6.2 Sol 與 DeepSeek V4.1 Flash 雲端比較 (簡體中文)。該測試的題目及評分方式與本文的測速不同,結果不可合併。
本文依 Crazyrouter 的歷史測試存檔整理,並於 2026 年 11 月 20 日重新計算統計數據。原始樣本、渠道核對紀錄及機器診斷索引均已在內部歸檔。以下註腳說明各組資料的來源與統計範圍。
作者:Sophie M · 整理日期:2026 年 11 月 20 日 · 資料日期:2026 年 11 月 3—4 日。
Footnotes#
-
2026-11-03 的四渠道主測試共 26 次正式請求。本文選取基準服務與 Spark 各六次請求,並交叉核對逐筆請求紀錄、彙整資料與用量紀錄。 ↩ ↩2 ↩3
-
資料來自主測試的回應模型欄位及 2026-11-04 的四節點機器檢查。僅確認回應識別碼與部署程序,無法據此驗證權重相同。 ↩
-
2026-11-04 01:04、14:14、20:24 三輪 Spark 複測,各進行六次請求。晚間三個由用戶端中斷的請求另行保留。 ↩ ↩2
-
2026-11-04 的機器診斷紀錄。未完成請求數依已完成請求的持續時間回推,包含等待中與執行中的請求。 ↩
-
2026-11-04 22:16 的直連與閘道配對補測,共兩組配對請求,輸入 26 token、輸出 256 token。 ↩
實作指南
最新節目
EP196 · 2026年10月29日 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 2026年10月28日 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.