简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
DeepSeek на 4 NVIDIA Spark: замеры самостоятельного развёртывания и сравнение с Crazyrouter V4.1 Flash 1017
Замеры 3–4 ноября 2026 года: DeepSeek на 4 NVIDIA Spark и Crazyrouter V4.1 Flash 1017. Скорость, кэш, обрывы и задержки. Совпадение весов не проверено.
Может ли DeepSeek, самостоятельно развёрнутый на четырёх NVIDIA Spark, по скорости приблизиться к готовому API? Мы изучили результаты тестов за 3–4 ноября 2026 года. В одном и том же раунде базовый сервис Crazyrouter выдавал токены быстрее. Последующие замеры Spark заметно различались в зависимости от времени суток: при низкой и высокой нагрузке сервис работал по-разному.
В сравнительном тесте 3 ноября на небольшой выборке медианная скорость генерации у базового сервиса Crazyrouter DeepSeek V4.1 Flash 1017 составила 147.31 token/s на коротком вводе и 136.87 token/s на длинном. У сервиса на четырёх Spark она составила 41.46 и 10.02 token/s соответственно. Обе стороны завершили 6/6 запросов на измерение скорости.1
В статье рассматривается работа сервиса после развёртывания: сколько приходится ждать первого фрагмента текста, с какой скоростью идёт потоковая выдача, попадает ли повторяющийся контекст в кэш и успевают ли запросы завершиться в пределах тестового лимита времени в часы высокой нагрузки. Данные взяты из архива. 20 ноября тесты заново не запускались, и эти результаты не гарантируют, что сервисы работают так же сейчас. Время везде указано по Пекину.
Одна ли версия у базового сервиса 1017 и у DeepSeek на Spark?#
Дополнительную информацию о семействе моделей и оборудовании можно найти на странице моделей DeepSeek у Crazyrouter (на английском) и на официальной странице NVIDIA DGX Spark. Выводы о производительности в прошлом опираются на архив тестов этой статьи.
В запросах к обеим сторонам указывалось имя модели deepseek-v4.1-flash, но в ответах возвращались разные имена:
| Объект сравнения | Имя модели в ответе | Что удалось подтвердить на тот момент |
|---|---|---|
| Базовый сервис DeepSeek у Crazyrouter | deepseek-v4.1-flash-1017 | Идентификатор в ответе содержал суффикс 1017 |
| DeepSeek, самостоятельно развёрнутый на четырёх Spark | deepseek-v4.1-flash | Проверка подтвердила, что на всех четырёх узлах GB10 работали процессы инференса (rank) |
В архиве нет полных сведений о хеше весов, точной ревизии и конфигурации квантования на стороне самостоятельного развёртывания. Поэтому DeepSeek V4.1 Flash 1017 в этой статье обозначает идентификатор, возвращённый базовым сервисом. Совпадение весов обеих сторон не подтверждено. Имя, возвращённое в ответе, само по себе не позволяет установить, какие веса использовались.2
При поиске по запросу «NVIDIA Spark deepseekv4.1flash1017 самостоятельное развёртывание» важно различать две проверки. Совместимость интерфейса и идентичность версии модели проверяются отдельно. Здесь сравниваются два маршрута обслуживания запросов в том виде, в каком они работали на момент теста. Для сравнения производительности самих GPU потребовалось бы зафиксировать остальные переменные.
Методика теста: единая точка входа, фиксированные каналы и лимит вывода#
В основном тесте 3 ноября запросы отправлялись через одну точку входа Crazyrouter по двум фиксированным каналам. Один вёл к базовому сервису, другой — к сервису на четырёх Spark. Ответы других каналов в результаты не включались. Конфигурация каналов в ходе теста не менялась.
В архивном тесте использовался следующий адрес:
Base URL: https://crazyrouter.com/v1
Endpoint: POST /chat/completions
Model: deepseek-v4.1-flash
Ниже приведены основные параметры измерения. Полный запрос также содержал один и тот же текст задания и префикс, различавший раунды:
{
  "model": "deepseek-v4.1-flash",
  "stream": true,
  "temperature": 0,
  "max_tokens": 768,
  "thinking": { "type": "disabled" }
}
Короткий ввод составлял 64 токена, длинный — 6,230 токенов. Для каждого варианта выполняли по три запроса. Текст длинного ввода повторяли, чтобы проверить попадание в кэш. Следующий запрос отправляли через шесть секунд после завершения предыдущего. Разные каналы тестировали параллельно, а внутри каждого канала запросы выполняли последовательно.
Полный раунд включал четыре канала и 26 зачётных запросов. В статье рассматриваются 12 запросов к базовому сервису и к Spark. Ещё два канала использовались для проверки диапазона результатов, а отдельный пробный запрос в статистику не вошёл. Для всех зачётных запросов каналы и число токенов сверили с журналом расхода.
Все запросы основного теста выдали по 768 токенов. Число токенов рассуждения было равно нулю. Запрос считался завершённым, если клиент получил сигнал штатного завершения потока и данные об использовании токенов. Остановка по заданному лимиту с finish_reason=length была предусмотрена методикой. Показатель 6/6 отражает завершение передачи в тесте скорости. По нему нельзя судить о правильности ответов или о том, довела ли модель рабочую задачу до естественного завершения.
Время до первого текста отсчитывали с момента отправки запроса клиентом. Для расчёта скорости генерации число выходных токенов делили на время между первым и последним фрагментами текста. Это приближённая оценка на стороне клиента, в которой учитываются токены первого фрагмента. Предшествующие затраты времени на соединение и очередь в неё не входят. В таблице приведены медианы по трём запросам.1
Результаты одного раунда: близкое время до первого текста и заметная разница в скорости генерации#
| Показатель | Базовый сервис Crazyrouter 1017 | Самостоятельное развёртывание на четырёх Spark |
|---|---|---|
| Завершено запросов | 6/6 | 6/6 |
| Короткий ввод: медиана времени до первого текста | 3.31 с | 3.25 с |
| Короткий ввод: медиана скорости генерации | 147.31 token/s | 41.46 token/s |
| Короткий ввод: медиана полного времени запроса | 9.05 с | 21.78 с |
| Длинный ввод: медиана времени до первого текста | 3.36 с | 7.73 с |
| Длинный ввод: медиана скорости генерации | 136.87 token/s | 10.02 token/s |
| Длинный ввод: медиана полного времени запроса | 9.09 с | 84.40 с |
| Полное время самого медленного запроса | 10.26 с | 156.11 с |
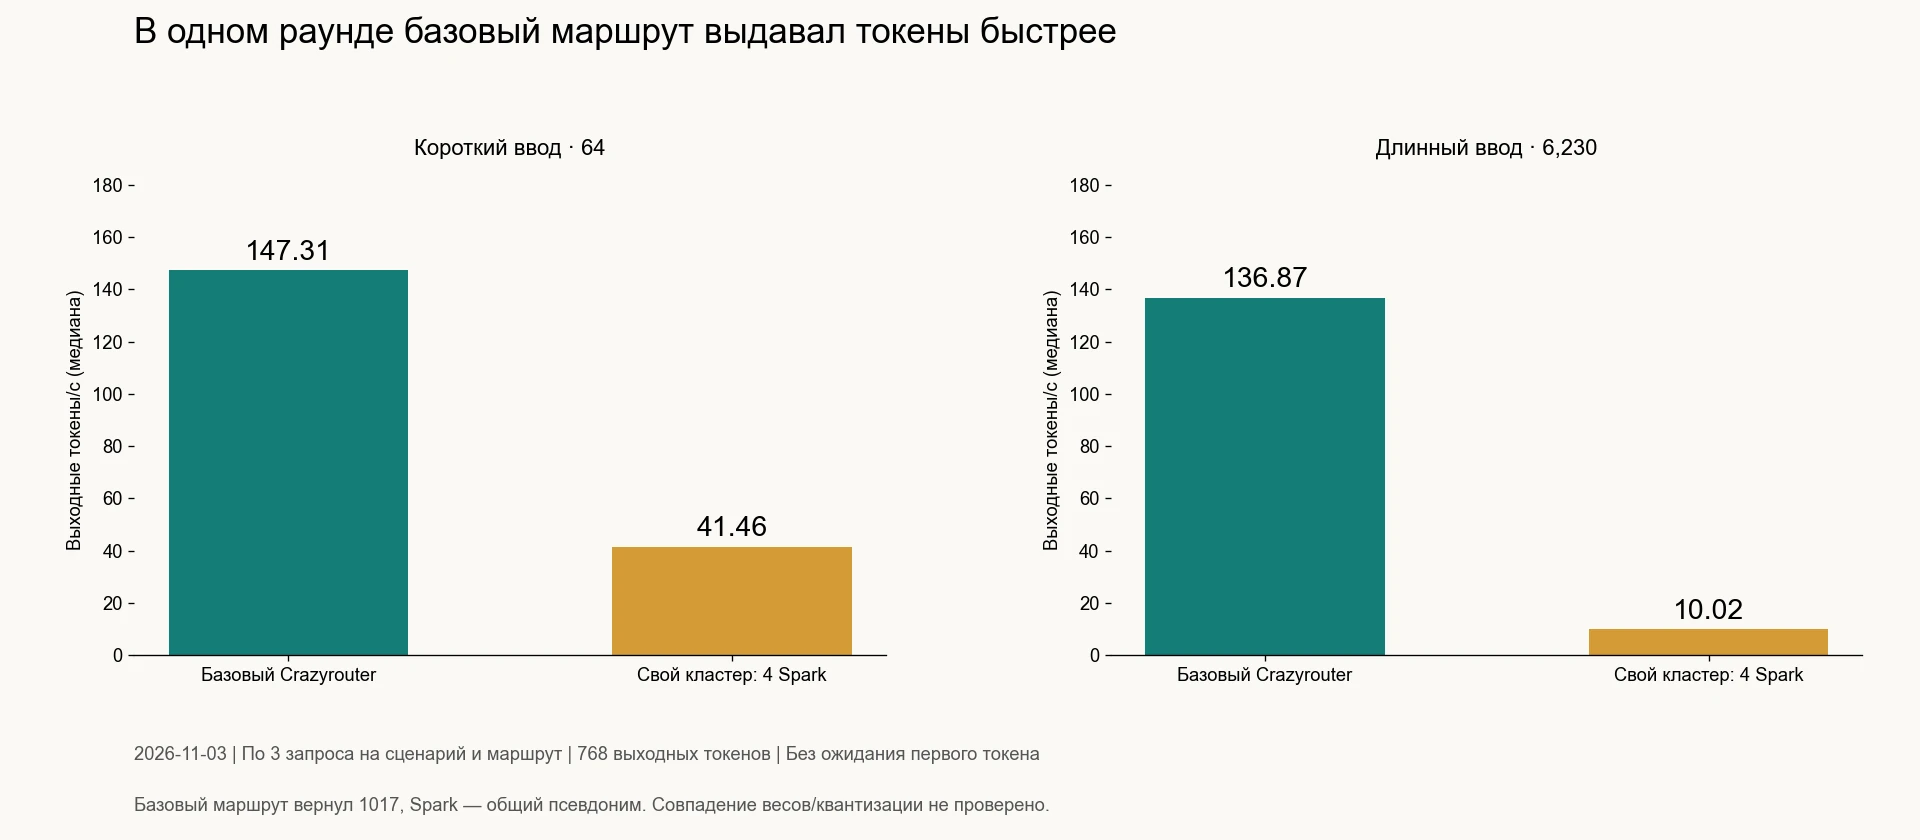
Рис. 1. 3 ноября 2026 года, по три запроса на каждый сценарий с каждой стороны. Время до первого текста не входит в расчёт скорости генерации. Совпадение весов и конфигураций квантования не проверено.
На коротком вводе первый фрагмент текста у Spark появлялся даже чуть раньше, однако дальнейшая генерация шла медленнее, поэтому полное время запроса было больше. По медиане скорости генерации базовый сервис опередил Spark примерно в 3.55 раза на коротком вводе и в 13.66 раза на длинном. Эти отношения характеризуют работу сервисов в данном раунде. По ним нельзя определить предел производительности четырёх Spark.
На Spark встречались и заметно более медленные запросы. Третий запрос с коротким вводом занял около 105.38 с при скорости примерно 7.47 token/s и всё же завершился штатно. Поэтому отсутствие ошибок и стабильность отклика следует оценивать отдельно. У двух других контрольных каналов медианы скорости генерации составили 143.69–148.13 token/s на коротком вводе и 130.20–141.49 token/s на длинном. Скорость базового сервиса в этом раунде укладывалась в диапазон, наблюдавшийся на других каналах.1
Почему скорость колеблется даже при попадании в кэш?#
Данные кэша для длинного ввода в основном тесте:
| Маршрут | Число токенов из кэша в трёх запросах с длинным вводом | Доля токенов из кэша в последнем запросе |
|---|---|---|
| Базовый сервис Crazyrouter | 0 → 6,144 → 6,144 | 98.62% |
| Самостоятельное развёртывание на четырёх Spark | 0 → 0 → 0 | 0% |
По этому раунду можно было бы ошибочно решить, что Spark не поддерживает кэширование. Последующие замеры показали обратное. При повторном тесте 4 ноября в 01:04 число токенов длинного ввода, взятых из кэша, составило 0 → 6,234 → 6,234, а в последнем запросе их доля достигла 99.98%. При этом медианная скорость генерации на длинном вводе составила всего 13.37 token/s. В трёх запросах было получено 13.37, 12.90 и 45.15 token/s соответственно. Скорость двух запросов с попаданием в кэш заметно различалась.3
В повторном тесте в 14:14 доля токенов из кэша в последнем запросе с длинным вводом составила 82.13%, а медианная скорость генерации достигла 57.91 token/s. Одной доли токенов из кэша недостаточно, чтобы объяснить скорость ответа в целом. Этот показатель также не равен проценту экономии, и в данном тесте по нему не рассчитывали преимущество в стоимости.
Насколько различались результаты одной и той же системы Spark в четырёх замерах?#
В последующих тестах использовались тот же текст задания и те же параметры вывода. У каждого раунда был свой префикс, поэтому короткий ввод составлял около 64–69 токенов, а длинный — около 6,230–6,235 токенов. На уровне отдельных токенов запросы различались.
| Время теста | Завершено запросов | Скорость генерации, короткий ввод | Скорость генерации, длинный ввод | Время до первого текста, короткий ввод | Время до первого текста, длинный ввод |
|---|---|---|---|---|---|
| 3 ноября, 23:43 | 6/6 | 41.46 token/s | 10.02 token/s | 3.25 с | 7.73 с |
| 4 ноября, 01:04 | 6/6 | 50.69 token/s | 13.37 token/s | 4.25 с | 3.61 с |
| 4 ноября, 14:14 | 6/6 | 56.70 token/s | 57.91 token/s | 2.04 с | 5.31 с |
| 4 ноября, 20:24 | 3/6 | 16.84 token/s* | 7.07 token/s* | 51.96 с* | 37.59 с* |
В вечернем раунде в статистику вошли только завершённые запросы: 2/3 с коротким вводом и 1/3 с длинным. Остальные три запроса прервались и не учитывались при расчёте медиан скорости и времени до первого текста.
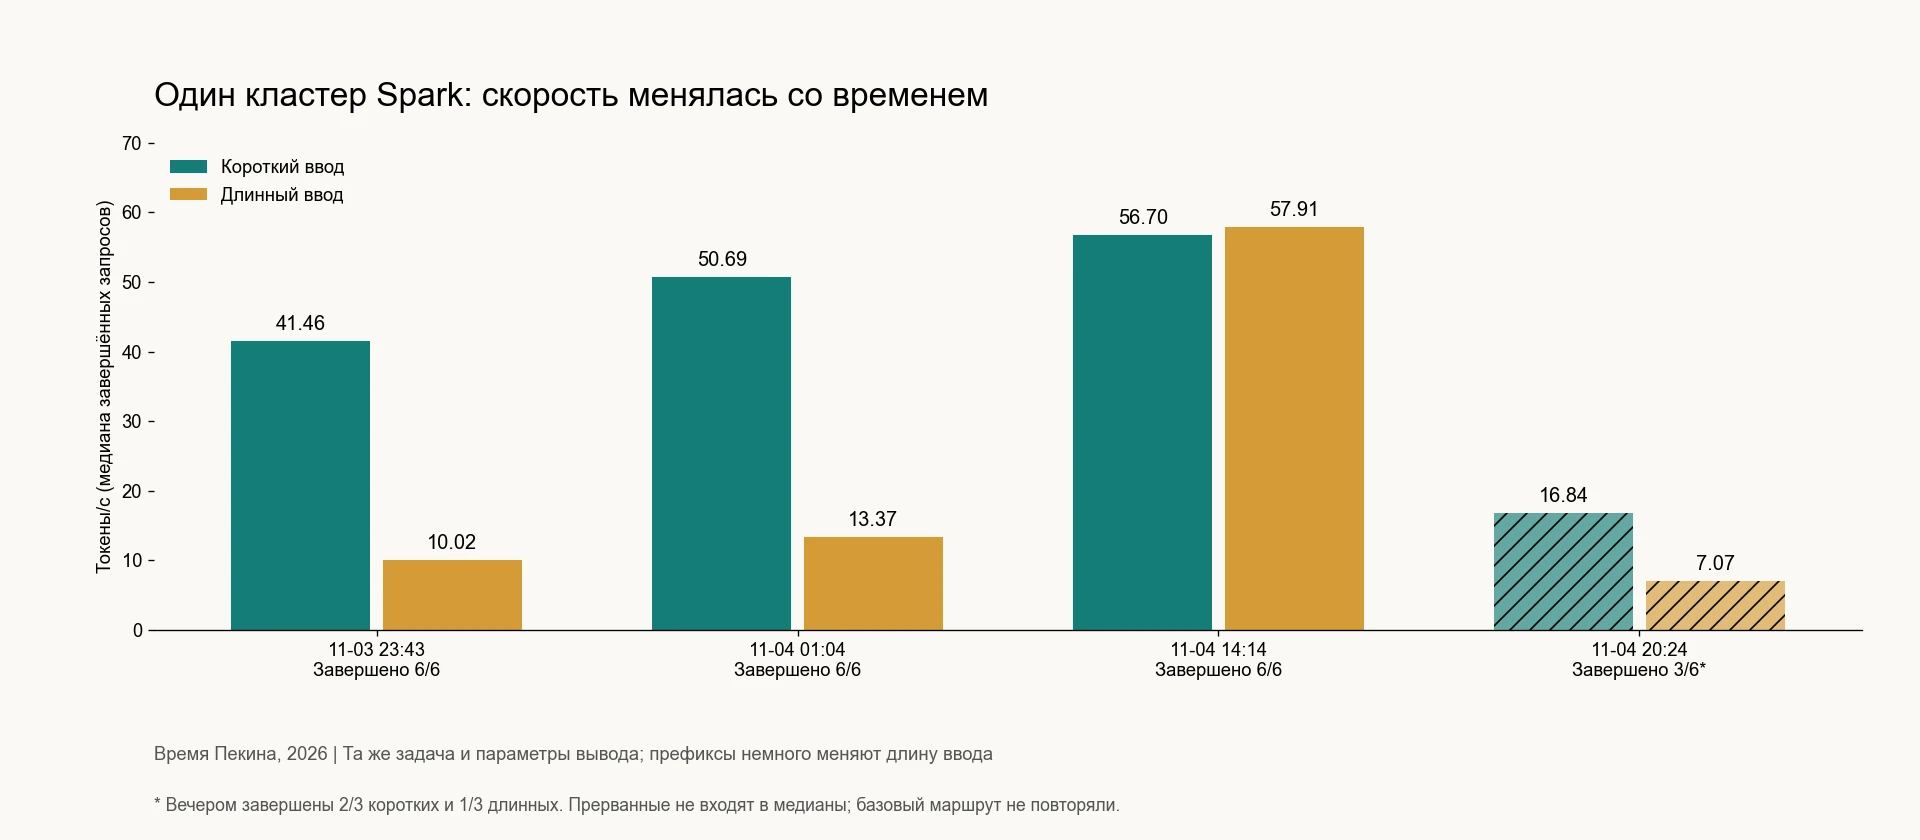
Рис. 2. В трёх последующих раундах повторно тестировали только Spark. Базовый сервис Crazyrouter одновременно с ним не тестировали. Его прежние результаты и более поздние замеры Spark нельзя объединять в одно контролируемое сравнение.
В трёх прерванных вечерних запросах клиент получил заголовки с кодом HTTP 200 и часть потокового ответа, но штатного завершения не было. Клиент прекратил вызовы примерно через 166–187 с. В журнале сайта эти случаи зафиксированы с кодом 499 (клиент разорвал соединение). Если считать только ответы HTTP 200, этот раунд ошибочно дал бы 6/6 завершённых запросов.3
Помимо снижения скорости у завершённых запросов, вечерний замер показал, что из шести запросов полностью завершились только три. Такой небольшой выборки недостаточно для оценки доступности сервиса в долгосрочной перспективе.
Откуда взялась задержка: данные указывают на нагрузку и очередь#
Проверка в режиме только чтения подтвердила, что процессы инференса работали на всех четырёх узлах GB10. На момент проверки были зафиксированы параметры slots=4 и peak_batch=4. Они описывают тогдашнюю конфигурацию движка. Предельная пропускная способность четырёх Spark может зависеть от ПО и модели.
В журналах одного и того же работающего сервиса зафиксированы два режима нагрузки:
- 4 ноября, 19:44, низкая нагрузка. По серверным журналам, запросы с вводом в 32 или 59 токенов и выводом в 256 токенов выполнялись со скоростью 104.8–156.8 token/s, а время до первого текста составляло 0.115–0.148 с. По восстановленным данным, в этот момент оставался только один незавершённый запрос. Запросов с вводом свыше 10,000 токенов среди незавершённых не было.
- 20:24, начало замера с медленными ответами. По времени окончания и длительности впоследствии завершённых запросов удалось установить, что как минимум 12 запросов с вводом свыше 10,000 токенов ещё не завершились. В сумме их ввод составлял около 1.53 млн токенов. На 20:33 другой срез показывал как минимум 16 таких незавершённых запросов.4
Эти числа — нижние оценки по архивным журналам. В них входят запросы в очереди и в обработке, поэтому по ним нельзя заключить, что 12 или 16 запросов одновременно декодировались на GPU. Источник остального трафика по архиву установить не удалось.
При низкой нагрузке Spark мог генерировать текст быстро. Когда множество запросов с длинным контекстом ещё не завершилось, клиент мог долго ждать появления текста. В часы высокой нагрузки ожидание наблюдалось и при прямых запросах к модели, поэтому всю задержку нельзя отнести на счёт шлюза Crazyrouter.
По имеющимся данным, задержку лучше всего объясняют нагрузка от длинных контекстов и конкуренция запросов в очереди. Без полной трассировки по этапам невозможно точно определить вклад планировщика, предварительной обработки контекста (prefill), декодирования и передачи данных. Скорость в 19:44 измерялась на сервере при коротких промптах и выводе в 256 токенов. Эти значения нельзя напрямую объединять с замерами основного теста, сделанными на клиенте при выводе в 768 токенов.
Увеличивает ли шлюз Crazyrouter задержку? В двух дополнительных парах время выросло#
4 ноября в 22:16 при сравнительно низкой нагрузке провели ещё два парных замера. В каждой паре запросы одновременно отправляли к одному и тому же сервису на Spark двумя маршрутами: напрямую через публичную сеть и через Crazyrouter. Ввод был одинаковым и составлял 26 токенов, лимит вывода — 256 токенов.
| Пара | Маршрут | Время до первого текста | Полное время запроса |
|---|---|---|---|
| 1 | Напрямую к Spark | 0.786 с | 3.779 с |
| 1 | Через Crazyrouter к тому же Spark | 6.150 с | 8.307 с |
| 2 | Напрямую к Spark | 1.031 с | 4.301 с |
| 2 | Через Crazyrouter к тому же Spark | 3.704 с | 7.496 с |
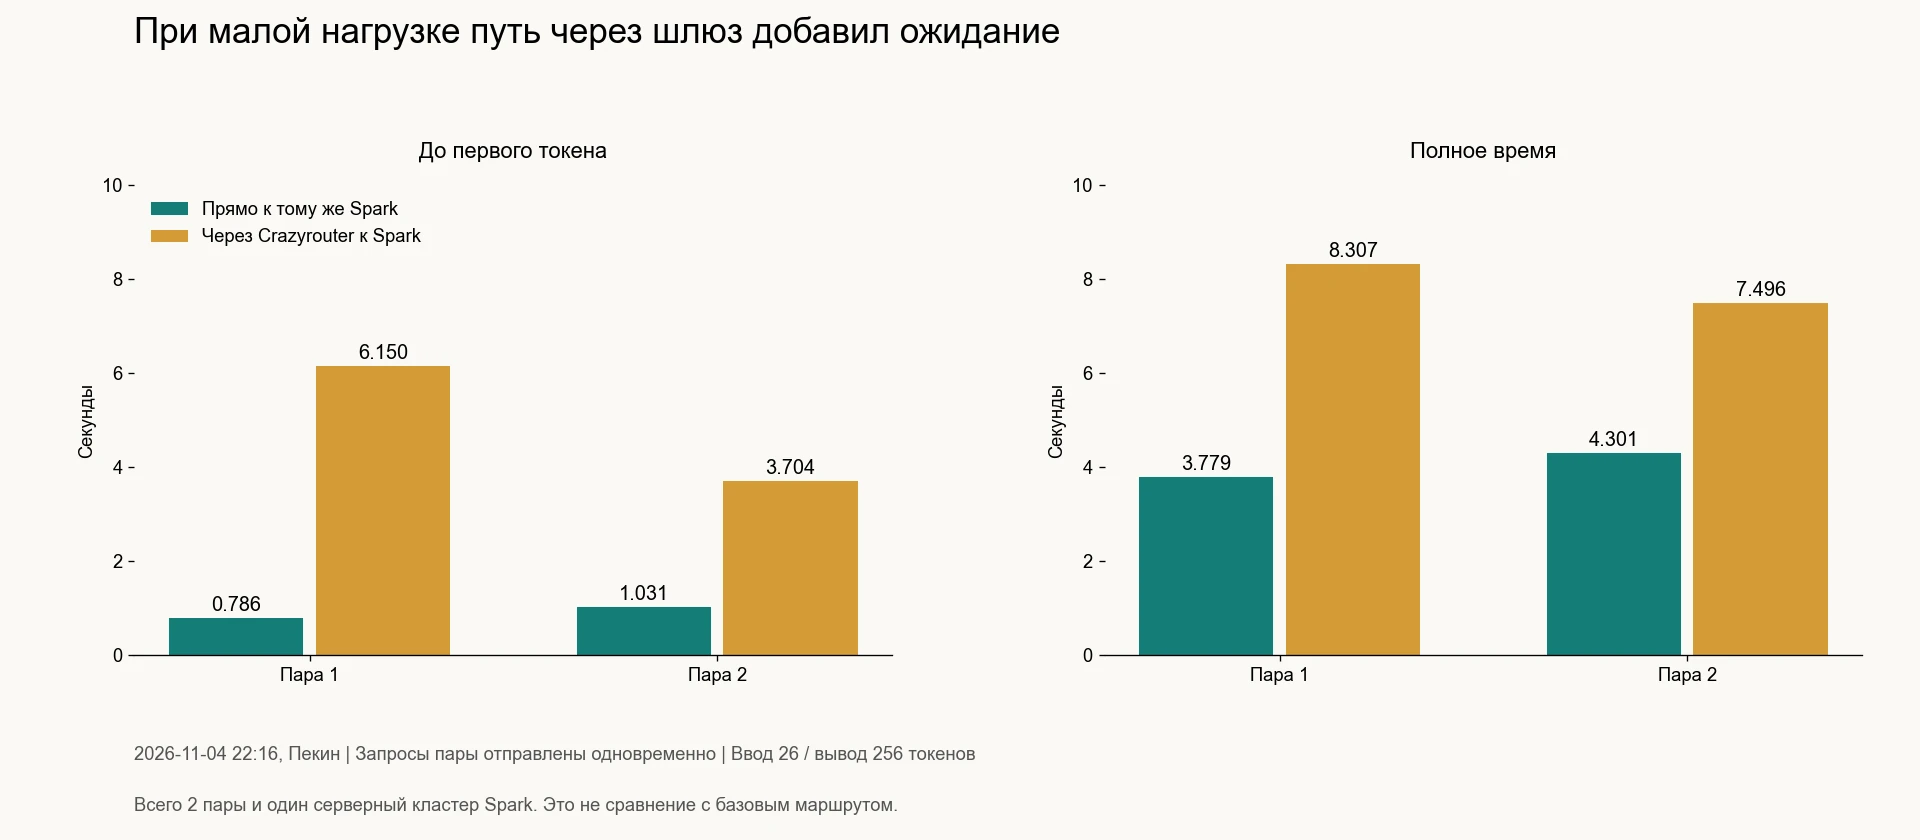
Рис. 3. Сравниваются маршруты к одному сервису Spark. Базовый сервис 1017 в этих замерах не участвовал. Запросы каждой пары отправлялись одновременно, но могли поступать в сервис инференса в разное время.
При обращении через шлюз полное время запроса увеличилось на 4.528 с и 3.195 с соответственно. Время обработки, зафиксированное на сервере, было близким. Это указывает на то, что часть разницы возникла до поступления запроса в сервис инференса. Двух пар запросов недостаточно, чтобы оценить отдельный вклад обработки на шлюзе, исходящего соединения и проброса доступа через публичную сеть. Считать эту разницу постоянной задержкой шлюза тоже нельзя.5
Выбор более быстрого вышестоящего сервиса и добавление прокси перед одним и тем же самостоятельно развёрнутым бэкендом — два разных решения. В общем раунде базовый сервис был быстрее. В двух дополнительных парах запросов полное время было меньше при прямом обращении к Spark.
Как использовать эти результаты при подготовке к самостоятельному развёртыванию?#
Архивные данные подтверждают, что на четырёх Spark можно запустить этот сервис DeepSeek. Для предсказуемого времени отклика приёмочные испытания должны охватывать больше сценариев, чем один замер при низкой нагрузке.
Командам, которые готовят развёртывание, мы рекомендуем включить в следующий раунд приёмочных испытаний четыре пункта:
- Зафиксировать версии и конфигурацию. Записать ревизию и хеш весов, параметры квантования, версию движка инференса и топологию. Одного псевдонима модели в API недостаточно для подтверждения её идентичности.
- Воспроизвести смешанную рабочую нагрузку. Включить короткие диалоги, контекст около 6K токенов и длинные запросы, которые будут встречаться в работе. Проверить, замедляются ли короткие запросы.
- Измерять время ожидания, скорость и долю завершённых запросов вместе. Сохранять данные всех прерванных запросов и рассчитывать P95/P99 после накопления достаточной выборки. Самый быстрый ответ не показывает, как сервис работает в остальных случаях.
- Сопоставить замеры на сервере и клиенте. Отдельно сравнить прямой доступ и доступ через шлюз при низкой и высокой нагрузке, чтобы определить, какой этап стоит оптимизировать.
Если для бизнеса приоритетна скорость ответа в условиях этого теста, базовый сервис Crazyrouter показал преимущество в одном общем раунде. Если цель — контролировать среду развёртывания и политику планирования запросов, замеры Spark можно использовать при подготовке приёмочных испытаний. Для решения о самостоятельном развёртывании потребуются дополнительные данные о пропускной способности, качестве ответов, восстановлении после сбоев и затратах на эксплуатацию.
Мы не измеряли стоимость покупки или аренды четырёх машин, расходы на электроэнергию, потребляемую мощность, загрузку оборудования и трудозатраты на обслуживание. Качество ответов также не оценивали. По результатам статьи нельзя установить, обходится ли самостоятельное развёртывание дешевле или какая из моделей лучше справляется с задачами.
Частые вопросы#
Может ли DeepSeek V4.1 Flash 1017 на четырёх NVIDIA Spark заменить API?#
По этим данным, сервис на четырёх узлах GB10 способен отвечать на запросы DeepSeek. При этом не подтверждено, что при самостоятельном развёртывании использовались веса той же ревизии 1017. Возможность заменить API в рабочем процессе зависит от фактической нагрузки, допустимого времени ответа, требований к качеству и эксплуатации. Вечерний результат 3/6 показывает, что нужны отдельные приёмочные испытания в часы высокой нагрузки.
Разница в 13.66 раза в основном тесте отражает разницу в производительности оборудования?#
Нет. Это отношение медианных скоростей генерации на длинном вводе в одном раунде. На него влияли различия в кэшировании, нагрузке, работе сервисов инференса и маршрутах доступа. По этому отношению нельзя судить о разнице в вычислительной мощности GPU.
Почему при попадании в кэш 99.98% токенов скорость оставалась низкой?#
В том раунде почти весь ввод попал в кэш, но медианная скорость генерации на длинном вводе составила 13.37 token/s. Доля токенов из кэша сама по себе не описывает общую скорость ответа. В архиве недостаточно данных о времени отдельных этапов, чтобы количественно оценить вклад каждого из них.
Может ли Spark выдавать больше ста токенов в секунду?#
В архивных серверных журналах при сравнительно низкой нагрузке, коротком вводе и выводе в 256 токенов зафиксировано 104.8–156.8 token/s. Методика отличается от основного теста, где скорость измеряли на клиенте при выводе в 768 токенов. Эти значения не гарантируют такую скорость при любой нагрузке.
Можно ли считать ответ HTTP 200 успешным вызовом?#
В вечернем тесте одного HTTP 200 было недостаточно. В трёх запросах клиент получил HTTP 200 и часть текста, после чего поток прервался без штатного завершения. По принятому критерию завершились 3/6 запросов, тогда как код HTTP 200 получили 6/6.
Что дешевле: самостоятельное развёртывание или Crazyrouter?#
Для вывода не хватает полных данных о затратах, собранных по единой методике. Чтобы сравнить стоимость, нужно сопоставить расходы на оборудование, степень его использования, затраты на эксплуатацию и повторы неудачных запросов с фактическими счетами за API при одном и том же объёме работы. Актуальные тарифы можно уточнить на странице цен Crazyrouter. Они не отражают фактическую стоимость архивного теста.
Материалы теста и дополнительное чтение#
Для подключения приложений можно воспользоваться руководством по интеграции Crazyrouter (на английском). Правильность решения задач и фактический расход рассматриваются в отдельном тесте «Облачное сравнение GPT-6.2 Sol и DeepSeek V4.1 Flash» (на китайском). Задания и методика оценки там отличаются от этого теста скорости, поэтому объединять результаты нельзя.
Статья подготовлена по архиву тестов Crazyrouter. Статистика пересчитана 20 ноября 2026 года. Исходные замеры, записи сверки каналов и указатель диагностических материалов по узлам сохранены во внутреннем архиве. В примечаниях указаны источники данных и состав каждой выборки.
Автор — Sophie M · Дата подготовки — 20 ноября 2026 года · Даты сбора данных — 3–4 ноября 2026 года.
Footnotes#
-
Основной тест четырёх каналов от 3 ноября 2026 года: 26 зачётных запросов. В статье использованы по шесть запросов к базовому сервису и к Spark. Записи отдельных запросов и сводные данные сверены с журналами расхода. ↩ ↩2 ↩3
-
Поле модели в ответах основного теста и проверка четырёх узлов от 4 ноября 2026 года. Подтверждены только возвращаемые идентификаторы и наличие процессов развёрнутого сервиса. Идентичность весов не установлена. ↩
-
Три повторных теста Spark 4 ноября 2026 года в 01:04, 14:14 и 20:24, по шесть запросов в каждом. Три вечерних запроса, прерванных клиентом, сохранены отдельно. ↩ ↩2
-
Диагностические записи по узлам от 4 ноября 2026 года. Число незавершённых запросов восстановлено по длительности завершённых запросов и включает запросы в очереди и в обработке. ↩
-
Дополнительный парный тест прямого доступа и доступа через шлюз 4 ноября 2026 года в 22:16. Всего две пары запросов, ввод 26 токенов, вывод 256 токенов. ↩
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Короткие выпуски для разработчиков (на английском): AI API, шлюзы, контроль затрат и инструменты для кода.
Новые выпуски
EP196 · 29 окт. 2026 г. · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28 окт. 2026 г. · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.