简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
DeepSeek auf 4 NVIDIA Spark im Praxistest – Vergleich mit der Crazyrouter-Baseline V4.1 Flash 1017
Tests vom 3.–4. November 2026: DeepSeek auf vier Spark-Systemen vs. Crazyrouter 1017. Tempo, Cache, Abbrüche, Latenz. Identische Gewichte unbestätigt.
Kann eine auf vier NVIDIA Spark selbst gehostete DeepSeek-Instanz bei realen Anfragen mit einer fertigen API mithalten? Wir haben die Tests vom 3.–4. November 2026 ausgewertet. Im direkten Vergleich innerhalb derselben Testrunde lieferte die Crazyrouter-Baseline ihre Ausgaben schneller. Bei den späteren Messungen schwankte die Leistung der Spark-Installation je nach Uhrzeit deutlich. Zwischen geringer und hoher Auslastung lagen große Unterschiede.
Im Vergleich mit kleiner Stichprobe vom 3. November lag die mediane Ausgabegeschwindigkeit der Crazyrouter-Baseline DeepSeek V4.1 Flash 1017 bei kurzen bzw. langen Eingaben bei 147.31 bzw. 136.87 token/s. Die auf vier Spark selbst gehostete Instanz erreichte 41.46 bzw. 10.02 token/s. Beide Seiten schlossen 6/6 Anfragen des Geschwindigkeitstests ab.1
Der Artikel untersucht das Verhalten der bereitgestellten Dienste bei API-Aufrufen. Gemessen wurden die Wartezeit bis zur ersten Textausgabe, die Geschwindigkeit der gestreamten Ausgabe, Cache-Treffer bei wiederholtem Kontext und der Abschluss von Anfragen innerhalb der Testfrist bei hoher Auslastung. Die Daten stammen aus dem Testarchiv. Am 20. November wurden keine neuen Tests durchgeführt. Die Ergebnisse sind keine Zusage zum aktuellen Zustand der Dienste. Alle Uhrzeiten sind in Peking-Zeit angegeben.
Verwenden die 1017-Baseline und die selbst gehostete Spark-Instanz dieselbe Version?#
Die Modellfamilie und die Spark-Hardware sind auf den unten verlinkten Produktseiten näher beschrieben. Die Aussagen zur damaligen Leistung stützen sich auf die archivierten Messungen. DeepSeek-Modellseite von Crazyrouter (auf Englisch) · Offizielle Produktseite zu NVIDIA DGX Spark
In beiden Anfragen stand damals der Modellname deepseek-v4.1-flash. Die zurückgegebenen Modellnamen unterschieden sich jedoch:
| Vergleichsobjekt | Modellname in der Antwort | Was sich damals bestätigen ließ |
|---|---|---|
| Crazyrouter-Baseline für DeepSeek | deepseek-v4.1-flash-1017 | Die Antwortkennung trägt das Suffix 1017 |
| Selbst gehostetes DeepSeek auf vier Spark | deepseek-v4.1-flash | Auf allen vier GB10-Knoten liefen laut Prüfung Prozesse für die Inferenz-Ranks |
Gewichtshash, genaue Revision und Quantisierungskonfiguration der selbst gehosteten Instanz sind im Archiv unvollständig dokumentiert. DeepSeek V4.1 Flash 1017 bezeichnet in diesem Artikel ausschließlich die Antwortkennung der Baseline. Ob beide Seiten dieselben Gewichte und dieselbe Quantisierung verwendeten, wurde nicht verifiziert. Der Modellname in der Antwort allein reicht zur unabhängigen Identifizierung der Gewichte nicht aus.2
Wer nach „NVIDIA Spark deepseekv4.1flash1017 selbst hosten“ sucht, sollte zwei Dinge getrennt prüfen. Ob eine Bereitstellung eine kompatible Schnittstelle bietet und ob sie exakt dieselbe Modellversion ausführt, erfordert jeweils einen eigenen Nachweis. Der Artikel vergleicht die beiden damals genutzten Dienstpfade. Für eine Rangfolge der GPU-Hardware müssten alle relevanten Variablen kontrolliert werden.
Testaufbau mit gemeinsamem Zugang, festen Kanälen und festem Ausgabebudget#
Im Haupttest vom 3. November liefen die Aufrufe über denselben Crazyrouter-Zugang und zwei fest zugewiesene Kanäle. Einer leitete zum Baseline-Dienst, der andere zum selbst gehosteten Dienst auf vier Spark. Antworten aus anderen Kanälen gingen nicht in die Ergebnisse ein. Die Kanalkonfiguration blieb während des Tests unverändert.
Für den damaligen Test wurde folgende Adresse verwendet:
Base URL: https://crazyrouter.com/v1
Endpoint: POST /chat/completions
Model: deepseek-v4.1-flash
Der folgende Auszug zeigt die wichtigsten Messparameter. Die vollständigen Anfragen enthielten außerdem denselben Aufgabentext und Präfixe zur Unterscheidung der Testrunden:
{
  "model": "deepseek-v4.1-flash",
  "stream": true,
  "temperature": 0,
  "max_tokens": 768,
  "thinking": { "type": "disabled" }
}
Die kurze Eingabe umfasste 64 Token, die lange 6,230 Token. Beide wurden je dreimal getestet. Der Haupttext der langen Eingabe wurde wiederholt, um Cache-Treffer zu beobachten. Die nächste Anfrage folgte jeweils sechs Sekunden nach Abschluss der vorherigen. Die Tests auf verschiedenen Kanälen liefen parallel, die Anfragen innerhalb eines Kanals nacheinander.
Die gesamte damalige Testrunde umfasste vier Kanäle und 26 reguläre Anfragen. Der Artikel betrachtet die 12 Anfragen an die Baseline und an Spark. Die beiden weiteren Kanäle dienten zur Einordnung der Ergebnisspanne. Ein separater Smoke-Test ging nicht in die Statistik ein. Kanal und Tokenzahlen aller regulären Anfragen wurden mit den Verbrauchsprotokollen abgeglichen.
Alle Anfragen im Haupttest lieferten 768 Ausgabetoken und null Reasoning-Token. Als „abgeschlossen“ galt eine Anfrage, wenn der Client das reguläre Ende des Streams und die Nutzungsdaten erhielt. Das Erreichen des Ausgabebudgets mit finish_reason=length war im Test vorgesehen. 6/6 abgeschlossene Anfragen sagen nichts über die Richtigkeit der Antworten oder darüber aus, ob das Modell eine fachliche Aufgabe selbstständig zu Ende geführt hat.
Für die Zeitmessung wurden zwei Größen erfasst. Die Wartezeit bis zur ersten Textausgabe beginnt mit dem Absenden der Anfrage durch den Client. Für die Ausgabegeschwindigkeit wurde die Zahl der Ausgabetoken durch die Zeit zwischen dem ersten und dem letzten Textblock geteilt. Dieser clientseitige Näherungswert zählt die Token des ersten Blocks mit und lässt die vorangegangene Verbindungs- und Warteschlangenzeit außen vor. Die Tabellen geben jeweils den Median aus drei Anfragen an.1
Ergebnisse derselben Testrunde: ähnliche Wartezeit bei kurzen Eingaben, deutlicher Unterschied im Ausgabetempo#
| Metrik | Crazyrouter-Baseline 1017 | Selbst gehostet auf vier Spark |
|---|---|---|
| Abgeschlossene Anfragen | 6/6 | 6/6 |
| Kurze Eingabe – mediane Wartezeit bis zur ersten Textausgabe | 3.31 Sekunden | 3.25 Sekunden |
| Kurze Eingabe – mediane Ausgabegeschwindigkeit | 147.31 token/s | 41.46 token/s |
| Kurze Eingabe – mediane Gesamtdauer | 9.05 Sekunden | 21.78 Sekunden |
| Lange Eingabe – mediane Wartezeit bis zur ersten Textausgabe | 3.36 Sekunden | 7.73 Sekunden |
| Lange Eingabe – mediane Ausgabegeschwindigkeit | 136.87 token/s | 10.02 token/s |
| Lange Eingabe – mediane Gesamtdauer | 9.09 Sekunden | 84.40 Sekunden |
| Gesamtdauer der langsamsten Einzelanfrage | 10.26 Sekunden | 156.11 Sekunden |
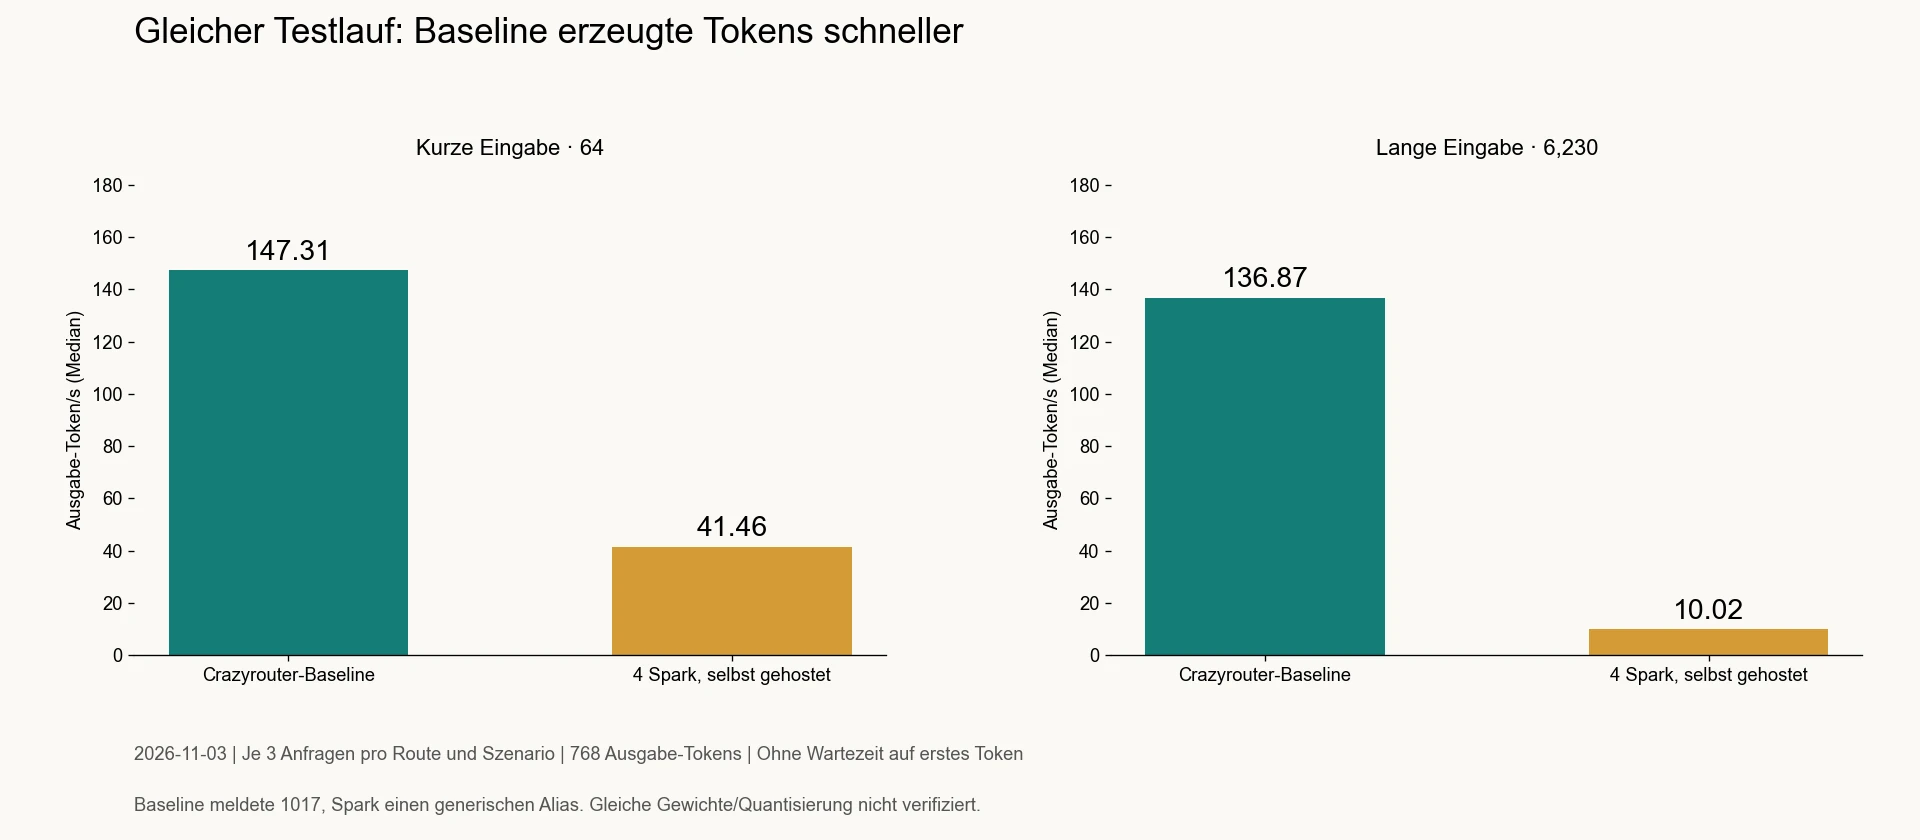
Abb. 1 – 3. November 2026, je drei Anfragen pro Seite und Szenario. Die Ausgabegeschwindigkeit lässt die Wartezeit bis zur ersten Textausgabe unberücksichtigt. Ob Gewichte und Quantisierung auf beiden Seiten übereinstimmten, wurde nicht verifiziert.
Bei kurzen Eingaben lieferte Spark den ersten Text sogar etwas früher. Die anschließende Generierung dauerte länger, sodass auch die Gesamtdauer höher ausfiel. Gemessen an der medianen Ausgabegeschwindigkeit erreichte die Baseline bei kurzen Eingaben etwa das 3.55-Fache und bei langen Eingaben etwa das 13.66-Fache des Spark-Werts. Diese Faktoren beschreiben den Zustand der Dienste in dieser Testrunde und erlauben keinen Rückschluss auf die Leistungsgrenze der vier Spark-Systeme.
Auch bei Spark gab es deutlich langsamere Einzelanfragen. Die dritte kurze Anfrage dauerte etwa 105.38 Sekunden und erreichte rund 7.47 token/s. Sie wurde vollständig abgeschlossen. Ein Aufruf kann also fehlerfrei enden und trotzdem deutlich länger dauern als die übrigen. Die beiden anderen Referenzkanäle erreichten mediane Ausgabegeschwindigkeiten von 143.69–148.13 token/s bei kurzen und 130.20–141.49 token/s bei langen Eingaben. Die Baseline lag damit in dieser Runde im Bereich der beiden Referenzkanäle.1
Warum schwankt die Geschwindigkeit trotz Cache-Treffern?#
Für die langen Eingaben im Haupttest wurden folgende Cache-Werte erfasst:
| Dienstpfad | Token aus dem Cache bei drei langen Eingaben | Cache-Anteil an der letzten Eingabe |
|---|---|---|
| Crazyrouter-Baseline | 0 → 6,144 → 6,144 | 98.62% |
| Selbst gehostet auf vier Spark | 0 → 0 → 0 | 0% |
Wer nur diese Runde betrachtet, könnte daraus schließen, dass Spark keinen Cache unterstützt. Die späteren Messungen zeigen Cache-Treffer. Beim Wiederholungstest am 4. November um 01:04 lagen die Werte für die langen Eingaben bei 0 → 6,234 → 6,234 Token aus dem Cache. Das entsprach bei der letzten Eingabe 99.98% der Eingabetoken. Die mediane Ausgabegeschwindigkeit bei langen Eingaben lag in dieser Runde dennoch bei 13.37 token/s. Die drei Anfragen erreichten 13.37, 12.90 und 45.15 token/s. Auch die beiden Anfragen mit Cache-Treffern unterschieden sich deutlich im Tempo.3
Beim Wiederholungstest um 14:14 lag der Cache-Anteil der letzten langen Eingabe bei 82.13%, während die mediane Ausgabegeschwindigkeit 57.91 token/s erreichte. Der Anteil der Token aus dem Cache erklärt die Geschwindigkeit der Antwort nur zum Teil. Aus dem Cache-Anteil lässt sich auch keine prozentuale Kostenersparnis ablesen. Ein Kostenvorteil wurde daraus in diesem Test nicht berechnet.
Wie stark unterschieden sich die Ergebnisse derselben Spark-Installation zu vier Uhrzeiten?#
Für die Wiederholungstests wurden derselbe Aufgabentext und dieselben Ausgabeparameter verwendet. Jede Runde hatte ein eigenes Präfix. Daher umfassten die kurzen Eingaben etwa 64–69 Token und die langen etwa 6,230–6,235 Token. Die Anfragen waren folglich nicht bis auf das einzelne Token identisch.
| Testzeit | Abgeschlossene Anfragen | Ausgabegeschwindigkeit bei kurzer Eingabe | Ausgabegeschwindigkeit bei langer Eingabe | Wartezeit bis zur ersten Textausgabe bei kurzer Eingabe | Wartezeit bis zur ersten Textausgabe bei langer Eingabe |
|---|---|---|---|---|---|
| 3. November, 23:43 | 6/6 | 41.46 token/s | 10.02 token/s | 3.25 Sekunden | 7.73 Sekunden |
| 4. November, 01:04 | 6/6 | 50.69 token/s | 13.37 token/s | 4.25 Sekunden | 3.61 Sekunden |
| 4. November, 14:14 | 6/6 | 56.70 token/s | 57.91 token/s | 2.04 Sekunden | 5.31 Sekunden |
| 4. November, 20:24 | 3/6 | 16.84 token/s* | 7.07 token/s* | 51.96 Sekunden* | 37.59 Sekunden* |
Die Mediane am Abend beruhen ausschließlich auf abgeschlossenen Anfragen. Bei kurzen Eingaben wurden 2/3 Anfragen abgeschlossen, bei langen 1/3. Die übrigen drei Anfragen brachen ab und gingen weder in den Median der Ausgabegeschwindigkeit noch in den der Wartezeit bis zur ersten Textausgabe ein.
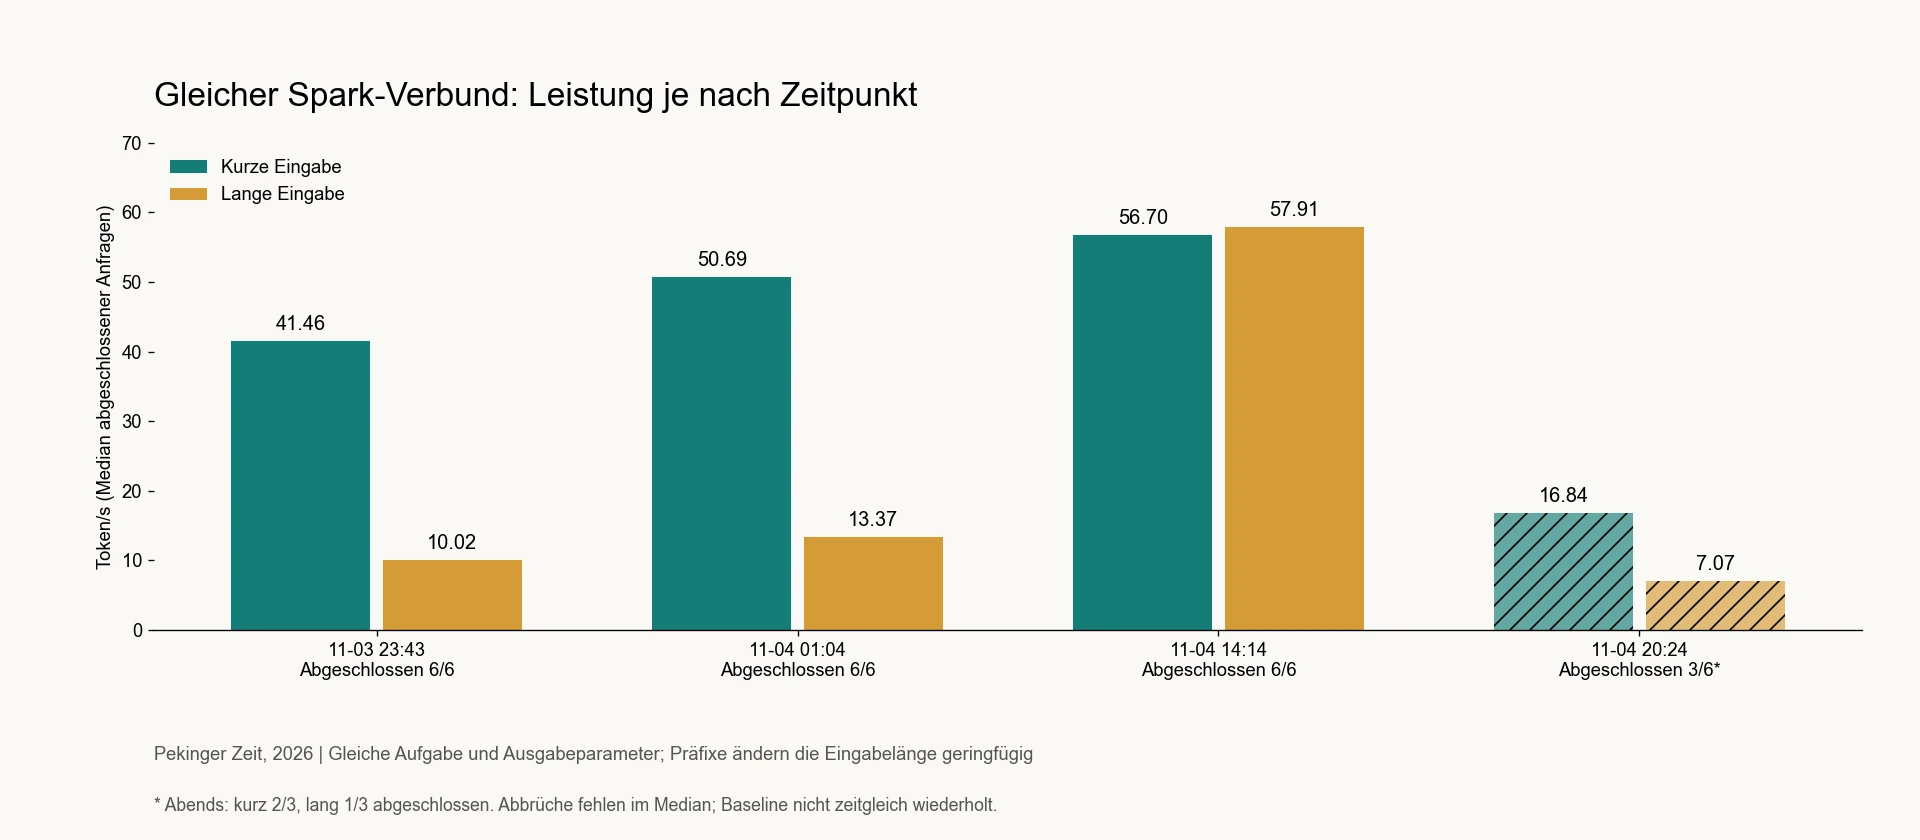
Abb. 2 – In den letzten drei Runden wurde nur Spark erneut gemessen. Die Crazyrouter-Baseline lief dabei nicht parallel. Die älteren Baseline-Werte und die späteren Spark-Messungen lassen sich daher nicht zu einem kontrollierten Vergleich innerhalb derselben Testrunde zusammenfassen.
Bei den drei abgebrochenen Anfragen am Abend gingen HTTP-200-Header und ein Teil der gestreamten Inhalte ein. Die Streams endeten jedoch nicht regulär. Der Client beendete die Aufrufe nach etwa 166–187 Sekunden. Das Protokoll der Website verzeichnete 499 (Client hat die Verbindung getrennt). Wer nur HTTP 200 zählt, würde diese Runde fälschlich mit 6/6 abgeschlossenen Anfragen verbuchen.3
Am Abend ging das Tempo der abgeschlossenen Anfragen zurück. Für die Bewertung dieser Runde ist vor allem relevant, dass nur drei von sechs Anfragen vollständig abgeschlossen wurden. Die kleine Stichprobe reicht für eine Schätzung der langfristigen Verfügbarkeit nicht aus.
Wo ging Zeit verloren? Die Aufzeichnungen deuten vor allem auf Last und Wartezeiten hin#
Bei einer schreibgeschützten Prüfung wurde bestätigt, dass auf allen vier GB10-Knoten Inferenzprozesse liefen. Die Momentaufnahme der Dienstkapazität zeigte slots=4 und peak_batch=4. Die Werte beschreiben die damalige Konfiguration der Inferenz-Engine. Die Kapazitätsgrenze der vier Spark-Systeme hängt auch von der eingesetzten Software und dem Modell ab.
Für denselben laufenden Dienst liegen Aufzeichnungen aus zwei unterschiedlichen Lastsituationen vor:
- 4. November, 19:44, geringere Auslastung. Laut Serverprotokoll erreichten Anfragen mit 32 oder 59 Eingabetoken und 256 Ausgabetoken 104.8–156.8 token/s. Die Zeit bis zur ersten Textausgabe lag bei 0.115–0.148 Sekunden. Aus den Protokollen ließ sich für diesen Zeitpunkt nur eine offene Anfrage rekonstruieren. Es gab keine offene Anfrage mit mehr als 10,000 Eingabetoken.
- 20:24, Beginn der langsamen Testrunde. Aus den Endzeitpunkten und Laufzeiten später abgeschlossener Anfragen ließ sich ableiten, dass mindestens 12 Anfragen mit jeweils mehr als 10,000 Eingabetoken noch offen waren. Zusammen umfassten sie rund 1.53 Millionen Token an Eingaben. Um 20:33 waren laut einer weiteren Momentaufnahme mindestens 16 solcher Anfragen offen.4
Die aus historischen Protokollen rekonstruierten Zahlen sind Untergrenzen und umfassen wartende wie laufende Anfragen. Daraus folgt nicht, dass die GPU gleichzeitig für 12 oder 16 Anfragen Token generierte. Woher der übrige Verkehr stammte, geht aus dem Archiv nicht hervor.
Bei geringer Auslastung konnte Spark schnell Text generieren. Wenn viele Anfragen mit langem Kontext gleichzeitig offen waren, mussten Clients unter Umständen lange auf die ersten Inhalte warten. Zu Stoßzeiten trat die Wartezeit auch bei Anfragen direkt an den Modelldienst auf. Das Crazyrouter-Gateway erklärt daher nur einen Teil der beobachteten Verzögerungen.
Am ehesten lassen sich die Verzögerungen durch die Last langer Kontexte und konkurrierende Anfragen in der Warteschlange erklären. Ohne vollständiges Tracing der einzelnen Phasen lässt sich die Verzögerung nicht genau auf Scheduling, Prefill, Dekodierung und Übertragung aufteilen. Die Geschwindigkeit um 19:44 wurde serverseitig mit kurzen Prompts und 256 Ausgabetoken erfasst. Sie lässt sich nicht direkt mit den clientseitigen Messwerten aus dem Haupttest mit 768 Ausgabetoken verrechnen.
Erhöht das Crazyrouter-Gateway die Latenz? In beiden ergänzenden Messpaaren ja#
Am 4. November um 22:16 wurden bei geringerer Auslastung zwei weitere Messpaare erfasst. Pro Paar wurden zwei Anfragen gleichzeitig an denselben selbst gehosteten Spark-Dienst gesendet, einmal direkt über das öffentliche Internet und einmal über Crazyrouter. Beide nutzten dieselbe Eingabe mit 26 Token und ein Ausgabebudget von 256 Token.
| Messpaar | Pfad | Wartezeit bis zur ersten Textausgabe | Gesamtdauer |
|---|---|---|---|
| 1 | Direkt zu Spark | 0.786 Sekunden | 3.779 Sekunden |
| 1 | Über Crazyrouter zum selben Spark-Dienst | 6.150 Sekunden | 8.307 Sekunden |
| 2 | Direkt zu Spark | 1.031 Sekunden | 4.301 Sekunden |
| 2 | Über Crazyrouter zum selben Spark-Dienst | 3.704 Sekunden | 7.496 Sekunden |
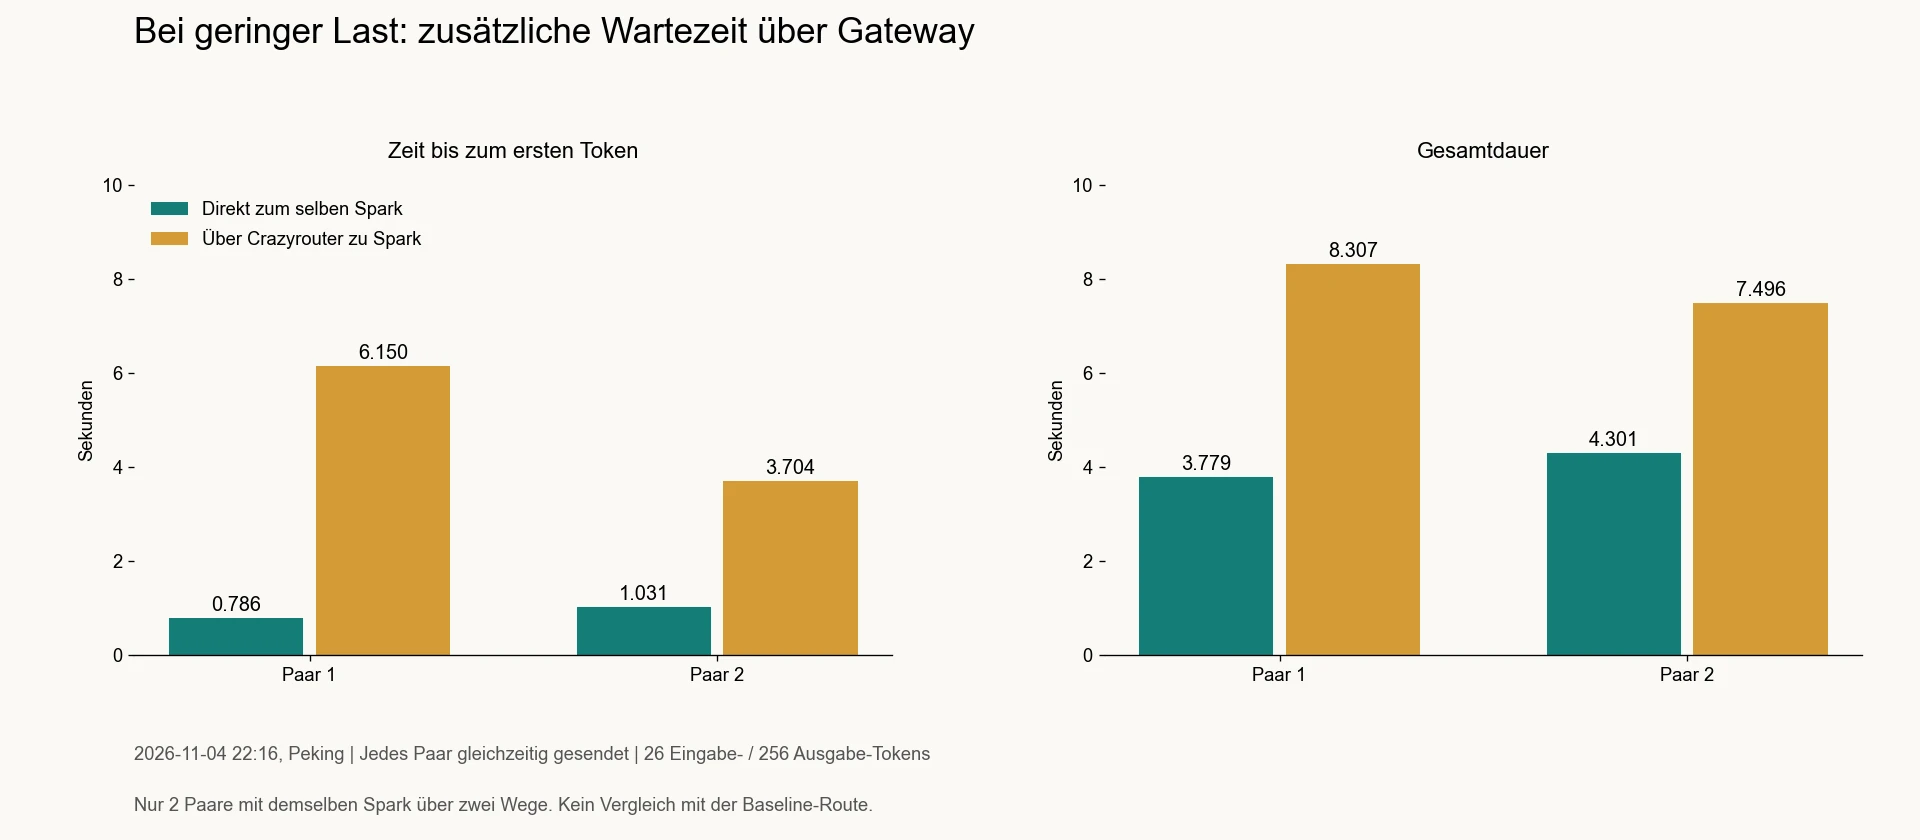
Abb. 3 – Verglichen werden zwei Zugriffswege zum selben Spark-Dienst. Die 1017-Baseline war an diesen Messungen nicht beteiligt. Die Anfragen eines Paars wurden gleichzeitig abgesendet, konnten aber zu unterschiedlichen Zeiten beim Inferenzdienst eintreffen.
Über das Gateway war die Gesamtdauer um 4.528 Sekunden bzw. 3.195 Sekunden länger. Die serverseitig aufgezeichneten Verarbeitungszeiten lagen nah beieinander. Das deutet darauf hin, dass ein Teil der zusätzlichen Wartezeit anfiel, bevor die Anfrage den Inferenzdienst erreichte. Aus zwei Messpaaren lässt sich weder ableiten, welcher Anteil auf die Gateway-Verarbeitung, die ausgehende Verbindung oder die öffentliche Netzwerkabbildung entfiel, noch wie hoch der typische zusätzliche Zeitaufwand durch das Gateway ist.5
Die Wahl eines schnelleren Upstream-Dienstes und das Hinzufügen einer Weiterleitung vor demselben selbst gehosteten Backend sind zwei verschiedene Entscheidungen. Die Baseline war im Vergleich innerhalb derselben Testrunde schneller. In den beiden ergänzenden Messpaaren war die Ende-zu-Ende-Dauer beim direkten Zugriff auf Spark kürzer.
Wie lassen sich die Ergebnisse für eine eigene Bereitstellung nutzen?#
Die Messungen zeigen, dass sich dieser DeepSeek-Dienst auf vier Spark-Systemen betreiben lässt. Wer vorhersagbare Antwortzeiten braucht, sollte bei der Abnahme auch unter höherer Last messen.
Für Teams, die eine eigene Bereitstellung vorbereiten, empfehlen wir vier Prüfschritte für die nächste Abnahme:
- Zuerst die Version festhalten. Gewichtsrevision, Hash, Quantisierung, Version der Inferenz-Engine und Topologie dokumentieren. Der API-Alias allein reicht zur Identifizierung derselben Modellversion nicht aus.
- Mit einem typischen Lastmix testen. Kurze Dialoge, Kontexte von rund 6K und lange Anfragen aus dem tatsächlichen Einsatz gemeinsam testen. Dabei prüfen, ob lange Anfragen die kurzen ausbremsen.
- Wartezeit, Ausgabegeschwindigkeit und Abschlussquote gemeinsam erfassen. Abgebrochene Anfragen vollständig dokumentieren und bei ausreichender Stichprobe P95/P99 berechnen. Die schnellste Einzelausgabe allein reicht zur Bewertung nicht aus.
- Server- und Client-Zeitmessungen aufeinander abstimmen. Direktzugriff und Gateway-Zugriff sowohl im Leerlauf als auch unter Last vergleichen, um die zu optimierende Phase einzugrenzen.
Wenn unter den hier getesteten Bedingungen die Antwortgeschwindigkeit Vorrang hat, schnitt die Crazyrouter-Baseline in derselben Testrunde besser ab. Wenn die Kontrolle über die Bereitstellungsumgebung und die Scheduling-Strategie im Vordergrund steht, können die Spark-Messungen als Grundlage für die Abnahme dienen. Für die Entscheidung über das Selbsthosting fehlen noch Daten zu Kapazität, Antwortqualität, Wiederherstellung nach Störungen und Betriebskosten.
Wir haben weder Kauf- oder Mietkosten für die vier Geräte noch Stromkosten, Leistungsaufnahme, Auslastung oder Wartungsaufwand erfasst. Die Antworten wurden auch nicht qualitativ bewertet. Ob Selbsthosting günstiger ist oder eines der beiden Modelle bessere Antworten liefert, lässt sich aus diesem Artikel nicht ableiten.
Häufig gestellte Fragen#
Kann ein auf vier NVIDIA Spark selbst gehostetes DeepSeek die API für DeepSeek V4.1 Flash 1017 ersetzen?#
Die Aufzeichnungen belegen, dass der Dienst auf vier GB10-Knoten DeepSeek-Anfragen beantworten konnte. Ob die selbst gehosteten Gewichte zur selben 1017-Revision gehörten, bleibt offen. Ob der Dienst eine API im praktischen Einsatz ersetzen kann, hängt von der tatsächlichen Last, den Antwortfristen, den Qualitätsanforderungen und dem Betriebsaufwand ab. Die 3/6 abgeschlossenen Anfragen am Abend zeigen, dass die Abnahme auch zu Stoßzeiten erfolgen muss.
Entspricht der Faktor 13.66 im Haupttest einem Unterschied in der Hardwareleistung?#
Nein. Er ist das Verhältnis der medianen Ausgabegeschwindigkeiten bei langen Eingaben innerhalb derselben Testrunde. Unterschiede beim Cache, bei der Last, beim Inferenzdienst und beim Zugriffsweg fließen in diesen Wert ein. Daraus lässt sich kein Faktor für die GPU-Rechenleistung ableiten.
Warum blieb die Ausgabe bei 99.98% Cache-Anteil langsam?#
In dieser Runde kamen fast alle Eingabetoken aus dem Cache. Trotzdem lag die mediane Ausgabegeschwindigkeit bei langen Eingaben bei 13.37 token/s. Die Cache-Trefferquote allein reicht zur Beurteilung der Gesamtgeschwindigkeit nicht aus. Die archivierten Zeitmessungen der einzelnen Phasen reichen nicht aus, um die jeweiligen Ursachen genauer zu beziffern.
Kann Spark mehr als hundert Token pro Sekunde ausgeben?#
Die damaligen Serverprotokolle verzeichneten bei geringer Auslastung, kurzer Eingabe und 256 Ausgabetoken 104.8–156.8 token/s. Diese serverseitige Messung unterscheidet sich methodisch vom clientseitigen Haupttest mit 768 Ausgabetoken. Sie erlaubt keine Zusage zur dauerhaft erreichbaren Ausgabegeschwindigkeit unter beliebiger Last.
Gilt HTTP 200 als erfolgreicher Aufruf?#
Im Abendtest reichte HTTP 200 dafür nicht aus. Drei Anfragen lieferten HTTP 200 und einen Teil der Inhalte, bevor die Übertragung abbrach. Weil nur vollständig beendete Anfragen zählen, lag die Abschlussquote bei 3/6 und nicht bei 6/6.
Was ist günstiger, Selbsthosting oder Crazyrouter?#
Für diese Aussage fehlen vollständige, nach denselben Kriterien erfasste Kostendaten. Für eine Kostenrechnung sollten Hardwarekosten, Auslastung, Betriebsaufwand und die Kosten von Wiederholungsversuchen nach Fehlern bei demselben Anfragevolumen der tatsächlichen API-Abrechnung gegenübergestellt werden. Aktuelle Preise sind keine Belege für die damaligen Testkosten. Preisseite von Crazyrouter
Testunterlagen und weiterführende Informationen#
Für die Anbindung eigener Anwendungen gibt es den Integrationsleitfaden von Crazyrouter (auf Englisch). Ein separater Test vergleicht die Korrektheit der Antworten und die tatsächlichen Nutzungskosten. Er verwendet andere Aufgaben und Bewertungsmethoden, weshalb seine Ergebnisse nicht mit denen dieses Geschwindigkeitstests zusammengeführt werden können. Cloud-Vergleich von GPT-6.2 Sol und DeepSeek V4.1 Flash (auf Chinesisch)
Dieser Artikel basiert auf dem historischen Testarchiv von Crazyrouter. Die Kennzahlen wurden am 20. November 2026 neu berechnet. Die Rohmessungen, die Nachweise zur Kanalzuordnung und das Verzeichnis der Systemdiagnosen sind intern archiviert. Die folgenden Anmerkungen nennen die Quellen der einzelnen Datengruppen und den Umfang der jeweiligen Auswertung.
Autorin: Sophie M · Aufbereitet am 20. November 2026 · Messzeitraum: 3.–4. November 2026.
Footnotes#
-
Haupttest vom 2026-11-03 mit vier Kanälen und 26 regulären Anfragen. Für diesen Artikel wurden je sechs Anfragen an die Baseline und an Spark ausgewählt. Einzelaufzeichnungen, Zusammenfassungen und Verbrauchsprotokolle wurden miteinander abgeglichen. ↩ ↩2 ↩3
-
Modellfeld in den Antworten des Haupttests und Prüfung der vier Knoten am 2026-11-04. Bestätigt wurden die Antwortkennungen und die laufenden Inferenzprozesse. Die Übereinstimmung der Gewichte wurde damit nicht nachgewiesen. ↩
-
Drei Spark-Wiederholungstests am 2026-11-04 um 01:04, 14:14 und 20:24 mit je sechs Anfragen. Die drei clientseitigen Abbrüche am Abend wurden separat erfasst. ↩ ↩2
-
Systemdiagnosen vom 2026-11-04. Die Anzahl der offenen Anfragen wurde aus den Laufzeiten abgeschlossener Anfragen rekonstruiert und umfasst wartende wie laufende Anfragen. ↩
-
Ergänzender Vergleich von Direkt- und Gateway-Zugriff am 2026-11-04 um 22:16. Zwei Anfragepaare mit 26 Eingabetoken und 256 Ausgabetoken. ↩
Implementation Guides
Podcast
AI Dev Tools: The Crazyrouter Podcast
Kurze Folgen (auf Englisch) für Entwickler: KI-APIs, Gateways, Kostenkontrolle und Coding-Tools.
Neueste Folgen
EP196 · 29. Okt. 2026 · 6:53
AI API Security Posture — Turn Controls Into Continuous Evidence
A practical guide to AI API security posture: inventory exposure, verify controls continuously, protect keys and data, constrain tools, and turn security assumptions into evidence that operators can act on.
EP195 · 28. Okt. 2026 · 7:21
AI API Policy Drift — Detect When Production Rules Stop Matching Intent
A practical guide to policy drift in AI APIs: version routing and safety rules, detect stale enforcement, compare intended and observed behavior, and restore control before small gaps become incidents.