 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
text-embedding-3-small 차원 설명: 품질과 비용을 위한 올바른 크기 선택 방법
text-embedding-3-small 차원에 대한 실용적인 가이드로, 256, 512, 1024, 1536 차원 중에서 선택하는 방법을 설명합니다.
text-embedding-3-small 차원 설명: 품질과 비용을 위한 올바른 크기 선택 방법#
1536차원에서 float32로 저장된 text-embedding-3-small 벡터 하나는 6,144바이트를 사용하므로, 벡터 1,000만 개에는 인덱스 오버헤드를 제외하고 약 61GB가 필요합니다. 검색이 작은 규모에서는 저렴해 보이다가, 코퍼스가 커진 뒤 메모리 비용이 오르고 쿼리 시간이 늘어나면서 이 숫자에 놀라는 팀이 많습니다. 더 어려운 점은 더 높은 차원이 어떤 데이터셋에서는 랭킹을 개선할 수 있지만, 다른 데이터셋에서는 같은 설정이 스토리지를 낭비하고 지연 시간을 늘릴 수 있다는 것입니다.
이것이 text-embedding-3-small 차원 설명의 핵심입니다. 모든 워크로드에서 이기는 보편적인 설정은 없습니다. 차원 크기는 관련성 목표, p95 지연 시간 한도, 벡터 스토리지 예산을 따로가 아니라 함께 테스트해서 선택해야 합니다. 품질만 튜닝하면 비용이 빠르게 증가합니다. 크기만 줄이면 사용자가 체감할 정도로 검색 품질이 떨어질 수 있습니다.
여기서는 실용적인 선택 방법을 다룹니다. 작은 평가 세트를 만들고, 두세 가지 차원 크기에서 관련성을 비교하며, 엔드투엔드 응답 시간을 측정하고, 차원 수를 벡터 100만 개당 실제 스토리지 비용으로 환산합니다. 그러면 적절한 크기는 추측이 아니라 측정 가능한 엔지니어링 선택이 됩니다.
text-embedding-3-small에서 "차원"이 의미하는 것과 결과가 달라지는 이유#
쉽게 말해, text-embedding-3-small 차원 설명이 뜻하는 것은 하나입니다. 각 벡터에 얼마나 많은 의미를 담아둘 것인가입니다. 차원 수는 품질 스위치가 아니라 압축 조절 장치입니다. text-embedding-3-small의 최대 크기는 1536차원입니다(지식 베이스의 모델 사양 기준). 더 낮은 크기는 더 강하게 압축합니다.
text-embedding-3-small 차원 설명: 의미를 숫자 벡터로 변환하기#
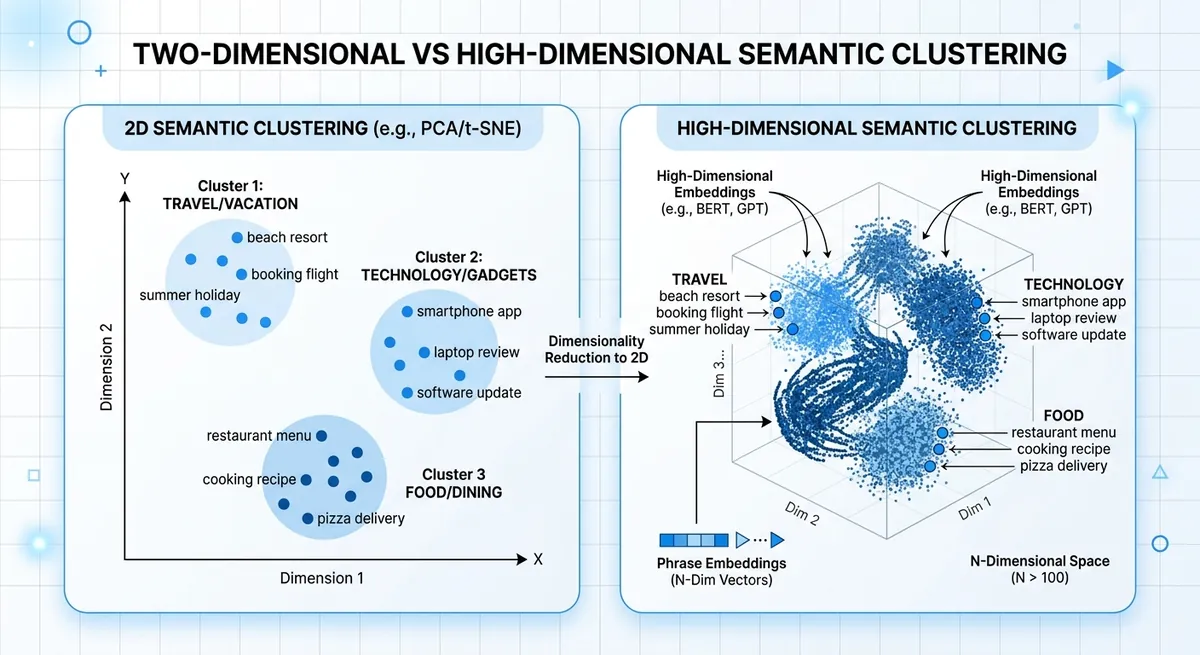
임베딩은 텍스트를 숫자로 바꾸어 비슷한 구문이 벡터 공간에서 서로 가깝게 위치하도록 합니다. "Reset my password"와 "I cannot sign in"은 가까운 위치에 있어야 합니다. 차원이 하나씩 늘어날수록 모델은 의도, 어조, 도메인 용어 같은 미묘한 정보를 저장할 공간을 더 많이 얻습니다. 벡터를 줄이면 핵심 의미는 유지되지만 더 세밀한 정보는 사라집니다.
text-embedding-3-small 차원 크기와 랭킹 품질 변화#
낮은 차원은 검색 속도를 높이고 스토리지를 줄일 수 있지만, 최근접 이웃 랭킹이 달라질 수 있습니다. 이 변화는 "cancel plan"과 "pause plan"처럼 겉으로는 비슷해 보이지만 수행해야 할 동작이 다른 두 의도에서 드러납니다.
| 벡터 크기 선택 | 의미 보존도 | 런타임 속도 | 벡터 1M개당 스토리지(float32) |
|---|---|---|---|
| 1536 (전체 text-embedding-3-small) | 가장 높은 세부 정보 보존 | 더 작은 벡터보다 느림 | ~6.1 GB |
| 768 (압축) | 일부 세부 정보 손실 | 더 빠름 | ~3.1 GB |
| 512 (압축) | 가까운 의도에서 더 큰 손실 위험 | 더 빠름 | ~2.0 GB |
출처: 제공된 지식 베이스의 text-embedding-3-small 최대 차원; 스토리지 계산은 차원 × 4바이트 기준.
이것이 text-embedding-3-small 차원 설명의 실무적 핵심입니다. 차원은 관련성 테스트, p95 지연 시간, 벡터 스토리지를 함께 보며 튜닝해야 합니다.
text-embedding-3-small 차원 옵션: 실용 범위와 트레이드오프#
text-embedding-3-small의 기본 벡터 크기는 1536차원입니다. 실제 시스템에서는 RAM, 디스크, ANN 인덱스 부하를 줄이기 위해 벡터를 줄이는 경우가 많습니다. 스토리지는 차원 수에 선형으로 증가하므로, 각 크기 선택은 곧 비용과 지연 시간 선택입니다. 이것이 text-embedding-3-small 차원 설명의 실무적 핵심입니다.
text-embedding-3-small 차원 설명: 일반 설정과 가장 잘 맞는 사용 사례#
대략적인 기본값이 필요하다면, 이 표를 A/B 테스트의 출발점으로 삼을 수 있습니다.
| 차원 | 벡터 1M개당 원시 스토리지(float32) | 가장 적합한 경우 | 일반적인 위험 |
|---|---|---|---|
| 256 | ~0.95 GB | 엄격한 지연 시간 또는 예산 제한, 단순 의도 매칭 | 미묘한 쿼리에서 누락 증가 |
| 384 | ~1.43 GB | 짧은 텍스트를 대상으로 한 비용 중심 의미 검색 | 예외 케이스에서 낮은 재현율 |
| 512 | ~1.91 GB | 지원 문서, 제품 도움말, FAQ를 위한 균형 잡힌 검색 | 롱테일 의미 일부 손실 |
| 768 | ~2.86 GB | 균형보다 품질을 조금 더 중시하는 검색, 혼합 쿼리 스타일 | 중간 수준의 인프라 비용 증가 |
| 1024 | ~3.81 GB | 밀도 높은 문서 대상 고재현율 RAG | 더 높은 인덱스 메모리와 쿼리 시간 |
| 1536 | ~5.72 GB | 전체 충실도 검색, 미묘한 유사도 판단 | 가장 높은 스토리지와 지연 시간 부담 |
출처: 차원 범위는 제공된 개요와 모델 정보(text-embedding-3-small = 1536) 기준입니다. 스토리지는 차원 × 4바이트 × 1,000,000개 벡터로 계산했습니다.
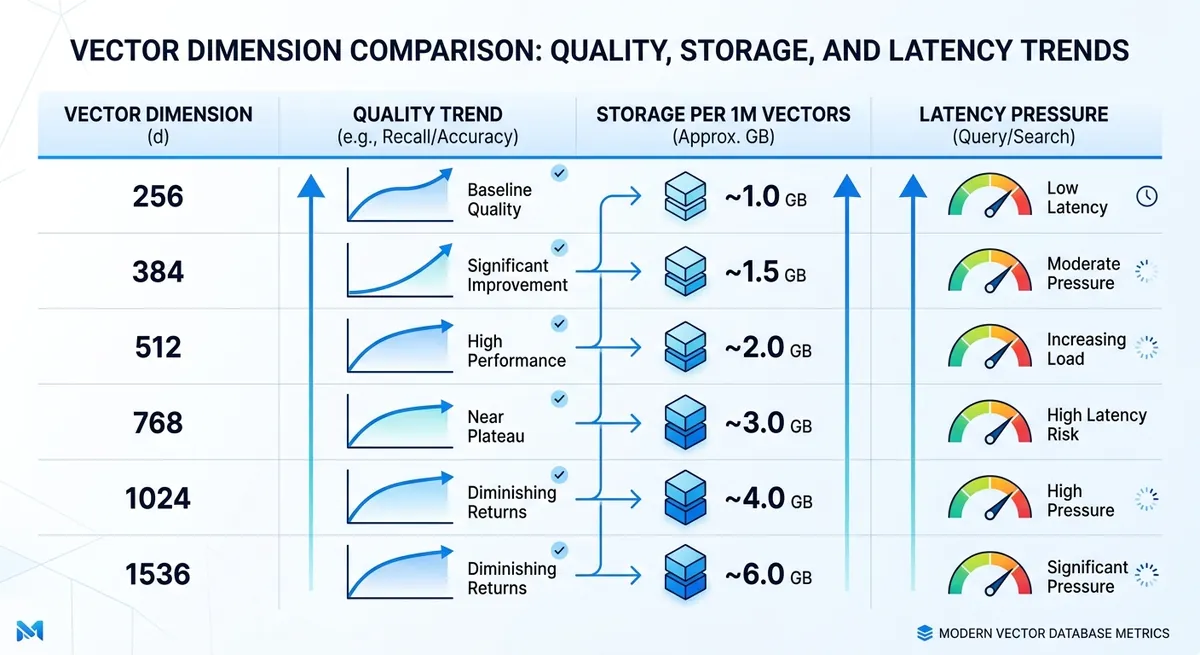
text-embedding-3-small 품질 트레이드오프: 성능 저하가 시작되는 지점#
품질 손실은 보통 정밀도가 중요한 작업에서 더 빨리 나타납니다. FAQ 검색은 384나 512에서도 사용할 만한 상태를 유지할 수 있지만, 법률 또는 의료 검색은 세밀한 의미 차이를 유지하기 위해 1024나 1536이 필요한 경우가 많습니다.
언어 혼합도 안전한 하한선을 바꿉니다. 단일 언어 영어 워크로드는 더 낮은 크기에서도 버틸 수 있습니다. 다국어 트래픽, 코드 스위칭, 혼합 스크립트는 벡터가 짧아질수록 더 빨리 저하되는 경향이 있습니다.
Crazyrouter를 사용하면 하나의 API 키로 이 테스트를 빠르게 실행하고, 동일한 평가 세트에서 512, 768, 1536의 검색 품질을 비교할 수 있습니다. 이렇게 하면 추측이 아니라 측정 가능한 기준점을 얻을 수 있습니다.
품질, 지연 시간, 비용: 실제로 필요한 3자 벤치마크#
이미 단일 지표가 왜 오해를 부를 수 있는지 봤습니다. text-embedding-3-small 차원 설명에서 실무적으로 해야 할 일은 하나의 관련성 목표, 하나의 지연 시간 예산, 하나의 스토리지 예산을 동시에 테스트하는 것입니다. p95 지연 시간 한도 안에서 품질 기준을 통과하는 가장 작은 차원을 선택하세요.
text-embedding-3-small 차원 테스트 세트: 신뢰할 수 있는 오프라인 관련성 만들기#
실제 검색 로그, 지원 티켓, 채팅 프롬프트를 사용하세요. 가능하다면 쿼리 예시 200~500개를 만드세요. 이 정도 크기는 팀의 속도를 늦추지 않으면서 취약한 지점을 드러내기에 충분합니다.
각 쿼리에서 "좋음"이 무엇을 의미하는지 라벨링하세요. 라벨은 단순하게 유지합니다. 관련 있음, 부분적으로 관련 있음, 관련 없음. 짧은 쿼리, 오타 쿼리, 도메인 용어, 다국어 쿼리처럼 어려운 케이스를 의도적으로 추가하세요. 앱이 여러 언어를 지원한다면 동일한 세트에 혼합 언어 쿼리를 포함하세요.
한 사람만 결과를 라벨링하게 두지 마세요. 리뷰어 두 명이면 편향을 빠르게 줄일 수 있습니다.
text-embedding-3-small 차원 벤치마크 지표: 품질과 지연 시간을 함께 보기#
한 번의 실행에서 랭킹 품질과 속도를 함께 추적하세요. Recall@k는 올바른 항목이 top-k 안에 나타나는지 알려줍니다. MRR과 nDCG는 사용자가 클릭하는 상위 위치에 해당 항목이 나타나는지 알려줍니다.
지연 시간은 경로를 나누어 봅니다. 임베딩 시간과 검색 시간입니다. 평균 지연 시간만 보지 말고 p95와 p99를 확인하세요. 느린 꼬리 요청이 사용자 경험을 결정합니다.
| 차원 후보 | 벡터당 알려진 크기(float32) | 상대 인덱스 메모리 | 추적할 품질 지표 | 추적할 지연 시간 지표 |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 스택 내 저차원 후보 | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
출처: Crazyrouter 모델 목록의 모델 차원(text-embedding-3-small: 1536, text-embedding-3-large: 3072). 바이트 계산은 float32 벡터 기준입니다.
text-embedding-3-small 차원 비용 모델: 스토리지를 비즈니스 영향으로 연결하기#
출시 전에 차원을 비용으로 환산하세요.
벡터 100만 개당 스토리지 = dimension × 4 bytes × 1,000,000이며, 여기에 복제본 수를 곱합니다. 벡터 데이터베이스의 인덱스 오버헤드도 더하세요.
<.-- IMAGE: Formula-style infographic for estimating vector storage and annual cost by dimension and corpus size. -->
이제 품질 향상을 CTR, 티켓 회피율, 전환율처럼 이미 추적 중인 비즈니스 신호와 연결하세요. 더 큰 차원이 nDCG를 약간 올리지만 메모리를 두 배로 늘리고 p95를 놓친다면 더 작은 설정을 유지하세요. 랭킹 관련성이 전환율을 움직일 만큼 충분히 개선된다면 명확한 비즈니스 근거가 생깁니다.
사용 사례별 올바른 차원 선택 방법#
아직 차원 크기를 추측하고 있다면, text-embedding-3-small 차원 설명의 이 부분이 지름길입니다. 차원을 워크로드에 매핑한 뒤, 출시 전에 작은 평가 세트로 검증하세요.
RAG와 엔터프라이즈 검색을 위한 text-embedding-3-small 차원 설명#
RAG와 내부 검색은 재현율이 떨어지면 빠르게 실패합니다. 사용자는 질문 하나를 던진 뒤, 상위 결과가 핵심 사실을 놓치면 이탈합니다. 따라서 출발점은 스토리지가 아니라 품질이어야 합니다.
text-embedding-3-small의 기준선으로 1536을 사용한 뒤, 어려운 쿼리에서 재현율을 확인한 후에만 더 낮은 크기 하나를 테스트하세요. 어려운 쿼리란 긴 질문, 희귀 용어, 혼합 의도를 의미합니다.
청킹은 사람들이 예상하는 것보다 결과를 더 크게 바꿉니다. 작은 청크와 낮은 차원을 함께 쓰면 컨텍스트를 두 번 잃을 수 있습니다. 한 번은 분할에서, 한 번은 임베딩에서입니다. 청크가 짧다면 더 높은 차원을 유지하세요. 청크가 길고 정돈되어 있다면 무작정 위험을 감수하지 않고 더 낮은 크기를 테스트할 수 있습니다.
추천, 클러스터링, 의미 라우팅을 위한 text-embedding-3-small 차원#
이런 시스템은 보통 완벽한 top-1 재현율보다 속도와 안정적인 그룹화를 더 중요하게 봅니다. 중간 설정이 가장 좋은 트레이드오프를 제공하는 경우가 많습니다.
라우팅에서는 2단계 모델이 재랭킹하거나 검증할 수 있기 때문에 근사 유사도만으로 충분한 경우가 많습니다. 즉 RAG에서보다 더 일찍 낮은 차원을 테스트할 수 있습니다. 클러스터링은 오프라인 실행 한 번만 보지 말고, 주간 데이터에서 클러스터 순도와 드리프트를 판단하세요.
다운스트림 지표가 두 번의 전체 트래픽 주기 동안 안정적으로 유지되는 가장 작은 차원을 선택하세요.
다국어 및 도메인 특화 워크로드를 위한 text-embedding-3-small 차원 설명#
도메인 언어는 판을 바꿉니다. 법률, 의료, 하드웨어 용어는 일반 언어에서는 가까워 보일 수 있지만 의미상으로는 멀 수 있습니다. 낮은 차원은 이런 경계를 흐릴 수 있습니다.
다국어 트래픽은 언어별 점검이 필요합니다. 모든 것을 하나의 점수로 평균 내지 마세요. 주요 언어 세그먼트별로 동일한 의도 세트를 실행한 뒤 누락 패턴을 비교하세요. 영어에서 잘 작동하는 크기가 혼합 언어 쿼리나 음역된 용어에서는 실패할 수 있습니다.
| 사용 사례 | 권장 시작 차원 | 낮추기 전에 측정할 항목 | 일반적인 실패 신호 |
|---|---|---|---|
| RAG / 엔터프라이즈 검색 | 1536 | 어려운 쿼리의 재현율, 답변 근거성 | 올바른 문서가 상위 결과에 없음 |
| 추천 | 중간(1536 미만 테스트) | CTR 또는 전환 안정성 | 비슷하지만 관련 없는 항목이 상승 |
| 의미 라우팅 | 중간에서 낮음 | 라우팅 정확도 + 폴백 비율 | 잘못된 라우트, 더 높은 폴백 |
| 다국어 / 도메인 비중 높음 | 1536 | 언어별 재현율, 용어 수준 오류 | 희귀 용어가 일반적인 의미로 매핑됨 |
출처: Crazyrouter 모델 목록의 모델 차원 정보(text-embedding-3-small: 1536, text-embedding-3-large: 3072). <.-- IMAGE: Decision matrix by use case (RAG, recsys, routing, multilingual) with recommended starting dimensions. -->
구현 가이드: API, 벡터 스키마, 마이그레이션 단계#
API 요청에서의 text-embedding-3-small 차원 설명#
text-embedding-3-small의 안전한 기준선은 1536차원입니다. dimensions 필드로 더 작은 크기를 요청할 수 있지만, 인덱스별로 해당 크기를 고정해야 합니다. 문서 벡터는 1024이고 쿼리 벡터는 1536이면 두 호출이 모두 성공하더라도 검색 품질은 흔들립니다.
쓰기 경로와 읽기 경로에 하나의 설정 값을 사용한 뒤, 모든 요청에서 검증하세요. 입력 텍스트가 비어 있지 않은지, 벡터 길이가 설정된 차원과 같은지, 모든 값이 실제 숫자인지(NaN 없음, Inf 없음) 확인합니다. 검증에 실패하면 해당 항목을 재시도 큐로 보내고 기본 크기로 다시 임베딩하세요.
OpenAI SDK를 https://crazyrouter.com/v1 같은 호환 엔드포인트와 함께 사용할 수 있으며, 모든 서비스가 사용하는 하나의 공유 설정 파일에서 모델과 차원을 고정할 수 있습니다.
벡터 스키마와 인덱스 설계에서의 text-embedding-3-small 차원 제어#
인덱스 하나에는 차원 하나만 사용하고, 쿼리 벡터와 문서 벡터를 같은 크기로 유지하세요.
kb_d1536_v1 및 kb_d1024_v1처럼 차원이 고정된 컬렉션 이름을 사용하세요. 이런 이름은 마이그레이션을 읽기 쉽게 만들고 조용히 섞이는 문제를 방지합니다.
<.-- IMAGE: Architecture diagram showing ingestion, embedding service, dual vector indexes, and query router. -->
차원이 바뀌면 새 벡터로 인덱스 설정을 다시 빌드하세요. HNSW의 경우 리빌드 후 그래프와 검색 설정을 다시 튜닝합니다. IVF의 경우 새 차원 크기의 벡터로 중심점을 다시 학습합니다. 기존 인덱스 학습 데이터를 재사용하면 재현율이 떨어질 수 있습니다.
이전 모델에서 마이그레이션할 때의 text-embedding-3-small 차원 설명#
마이그레이션은 단계적으로 진행하세요.
| 단계 | 쓰기 경로 | 읽기 경로 | 확인할 항목 |
|---|---|---|---|
| Dual-write | Old + new embeddings | Old index | 쓰기 성공률과 벡터 검증 오류 |
| Shadow-read | Old + new embeddings | 사용자는 old를 보고, new는 로그만 남김 | Top-k 중복도, 지연 시간, 나쁜 쿼리 케이스 |
| Cutover | Old + new embeddings | New index | 관련성 통과율과 p95 지연 시간 목표 |
| Rollback | Dual-write 활성 유지 | Old로 다시 전환 | 오류 급증 또는 관련성 하락 시 트리거 |
출처: Crazyrouter 지식 베이스(text-embedding-3-small은 1536차원; OpenAI 호환 API; 300개 이상 지원 모델).
이것이 text-embedding-3-small 차원 설명의 실무적 핵심입니다. 차원을 고정하고, 섀도 트래픽으로 테스트한 뒤, 측정된 동등성이 확인된 후에만 전환하세요.
프로덕션 운영: 드리프트, 품질 회귀, 팀 워크플로 모니터링#
오프라인 테스트로 차원 크기를 선택했습니다. 좋은 시작입니다. 실제 위험은 나중에 나타납니다. 새 콘텐츠, 새 쿼리 조합, 랭킹 변화가 프로덕션에 들어온 뒤입니다. text-embedding-3-small 차원 설명에서 장기 품질은 고정된 평가 데이터, 라이브 동작 점검, 통제된 출시 단계라는 촘촘한 루프에서 나옵니다.
text-embedding-3-small 차원 드리프트 모니터링 설정#
각 차원 변경 전에 평가 세트와 지표를 고정하세요. 실제 사용자 의도와 맞는 골든 쿼리 세트를 유지한 뒤, 매주 같은 기준으로 점수를 매기세요. 여기에 라이브 신호를 결합하면 지원 티켓이 쌓인 뒤가 아니라 초기에 드리프트를 잡을 수 있습니다.
| 신호 | 드리프트의 모습 | 리뷰 주기 | 조치 트리거 |
|---|---|---|---|
| 골든 세트 관련성 점수 | 상위 결과가 알려진 정답과 맞지 않기 시작함 | 주간 스코어카드 | 마지막 안정 실행 대비 하락 |
| 검색 블록의 CTR | 사용자가 추천 문서를 덜 클릭함 | 매일 | 지속적인 하락 |
| 작업 성공률 | 목표 작업을 완료하지 못하는 세션 증가 | 매일 | 세그먼트별 하락 추세 |
| 결과 없음 비율 | 빈 검색 응답 증가 | 매일 | 배포 후 급증 |
표 출처: 이 섹션에서 사용하는 운영 런북 패턴(제공된 개요의 골든 세트 + 온라인 지표).
<.-- IMAGE: dashboard mock showing weekly golden-set score, CTR trend, no-result rate, and alert thresholds -->
스테이징과 프로덕션에서 text-embedding-3-small 차원 실험을 안전하게 실행하기#
최근 7~14일의 재생 쿼리를 사용해 스테이징에서 시작하세요. 프로덕션으로 이동할 때는 카나리 슬라이스로 시작한 뒤 사용자 세그먼트와 지역별로 확장하세요. 롤백은 준비된 상태로 유지합니다. 품질이 떨어지면 트래픽 증가를 멈추고 마지막 안정 차원으로 전환한 뒤, 실패한 쿼리 유형을 기록하세요. 이렇게 하면 사고 시간을 줄이고 다음 테스트에 필요한 깨끗한 데이터를 얻을 수 있습니다.
text-embedding-3-small 차원 설명 실험을 위한 팀 워크플로#
팀 간 평가는 사람들이 섞인 브라우저 세션에서 테스트하면서 자주 깨집니다. SEO, 제품, ML이 서로의 상태를 덮어쓸 수 있고, 그러면 아무도 결과를 신뢰하지 않습니다. DICloak 격리 프로필을 사용하면 각 역할이 세션 충돌이나 계정 교차 없이 동일한 빌드를 테스트할 수 있습니다.
DICloak 같은 도구를 사용하면 프로필별로 고정 프록시와 세션 규칙을 설정할 수 있습니다. 즉 "US-English account"와 "EU account" 테스트가 매번 안정적인 네트워크 조건에서 실행됩니다. 재현 가능한 설정은 차원 기반 랭킹 점검을 팀원 간에 더 쉽게 비교하게 해주며, 지속적인 text-embedding-3-small 차원 설명 작업을 위한 반복 가능하고 안전한 경로를 제공합니다.
흔한 실수와 최종 차원 선택 체크리스트#
여기까지 읽었다면, text-embedding-3-small 차원 설명은 추측이 아니라 출시 결정으로 끝나야 합니다.
프로덕션을 망가뜨리는 text-embedding-3-small 차원 실수#
| 실수 | 발생하는 문제 | 해야 할 일 |
|---|---|---|
| 벤더 벤치마크 점수만 신뢰함 | 테스트에서는 검색이 괜찮아 보이지만 실제 쿼리에서는 의도를 놓침 | 실제 사용자 쿼리로 내부 평가 세트를 만든 뒤, 각 차원 설정을 해당 세트에서 채점 |
| 스토리지 비용만 줄이고 품질 점검을 건너뜀 | 낮은 벡터 크기로 비용은 절감되지만 클릭 품질이 떨어지고 지원 티켓이 증가 | 출시 전 검색 품질과 사용자 행동을 함께 추적 |
| 관련성만 테스트함 | 빠른 인덱스 설정도 p95 목표에는 실패할 수 있음 | 엔드투엔드 지연 시간 측정: 임베딩 + 인덱스 검색 + 재랭킹 |
text-embedding-3-small 차원 설명 출시를 위한 최종 10가지 체크리스트#
- 소스 데이터의 중복과 깨진 텍스트를 정리합니다.
- 벤치마크에 헤드, 미드, 테일 쿼리를 포함합니다.
- 최소 두 가지 크기를 비교합니다: 1536 (text-embedding-3-small) 및 3072 (text-embedding-3-large).
- 동일한 쿼리 세트에서 각 크기의 top-k 관련성을 기록합니다.
- API 호출부터 최종 랭킹 결과까지의 p95 지연 시간을 기록합니다.
- 차원 수를 벡터 100만 개당 스토리지 비용으로 환산합니다.
- 실제 트래픽과 성공 지표로 카나리를 실행합니다.
- 전체 출시 전에 롤백 단계를 준비합니다.
- 모니터링과 알림 대응 담당자를 한 명 지정합니다.
- 재학습 또는 재임베딩 검토 주기를 설정합니다.
관련성, p95 지연 시간, 스토리지 비용이 함께 통과할 때만 출시하세요.
<.-- IMAGE: One-page launch checklist graphic for embedding dimension decisions. -->
자주 묻는 질문#
text-embedding-3-small 차원 설명에서 시작하기 가장 좋은 기본 차원은 무엇인가요?#
대부분의 팀에는 512가 실용적인 시작점이며, 콘텐츠가 복잡한 경우(법률, 기술, 장문 문서)에는 1024가 적합합니다. text-embedding-3-small 차원 설명에서 이는 초기에 과도하게 투자하지 않으면서 품질, 속도, 비용의 강한 균형을 제공합니다. 그런 다음 실제 사용자 쿼리와 예상 필터를 사용해 작은 벤치마크를 실행하세요. 장난감 테스트에서 가장 좋아 보이는 값이 아니라, 관련성 목표를 충족하는 가장 작은 차원을 선택하세요.
text-embedding-3-small 차원 설명에서 차원을 낮추면 항상 검색 품질이 떨어지나요?#
낮은 차원이 항상 의미 있는 수준으로 결과를 해치지는 않습니다. 짧은 FAQ 검색이나 좁은 도메인에서는 하락폭이 작을 수 있습니다. 넓은 카탈로그, 다국어 콘텐츠, 미묘한 의미 매칭에서는 품질이 더 빠르게 떨어질 수 있습니다. text-embedding-3-small 차원 설명에서는 차원을 튜닝 조절 장치로 다루세요. 동일한 쿼리 세트에서 256, 512, 1024를 비교합니다. 실제 사용자에게 허용 가능한 Recall@k와 랭킹 품질을 유지하는 가장 작은 크기를 선택하세요.
text-embedding-3-small 차원은 벡터 데이터베이스 비용에 어떤 영향을 주나요?#
비용은 대략 차원 수에 선형으로 비례합니다. 벡터를 1024에서 512로 줄이면 원시 벡터 스토리지는 약 절반이 됩니다. RAM 사용량과 종종 쿼리 연산량에도 같은 추세가 적용됩니다. 하지만 인덱스 오버헤드를 포함해야 합니다. ANN 구조는 그래프 링크, 메타데이터, 내부 관리 정보를 위해 메모리를 추가로 사용합니다. 따라서 전체 절감 효과는 크지만, 벡터 바이트만 줄어드는 것은 아닙니다. 실제로는 최종 차원을 정하기 전에 임베딩 크기만이 아니라 전체 인덱스 크기를 추정하세요.
차원을 변경할 때 모든 문서를 다시 임베딩해야 하나요?#
예. 한 차원에서 만들어진 벡터는 다른 차원의 벡터와 하나의 일관된 인덱스 안에서 섞을 수 없습니다. 차원을 변경하면 모든 문서를 다시 임베딩하고 인덱스를 다시 빌드해야 합니다. 프로덕션 시스템에서는 더 안전한 마이그레이션을 사용하세요. 이중 인덱스 출시를 실행합니다. 새 인덱스를 병렬로 구축하고, 트래픽 일부를 보내 품질과 지연 시간을 비교한 뒤, 완전히 전환합니다. 이렇게 하면 다운타임을 피하고 전환 중 검색 동작을 안정적으로 유지할 수 있습니다.
차원을 비교할 때 어떤 지표를 추적해야 하나요?#
관련성, 속도, 비용이라는 세 그룹을 추적하세요. 관련성에는 라벨링된 쿼리 세트의 Recall@k, nDCG, MRR을 사용합니다. 속도는 p50/p95/p99 지연 시간을 확인하세요. 꼬리 지연 시간이 사용자 경험에 영향을 주기 때문입니다. 비용은 문서 100만 개당 스토리지, RAM 사용량, 쿼리 1,000개당 비용을 측정합니다. text-embedding-3-small 차원 설명에서 이 스코어카드는 스토리지는 줄였지만 랭킹 품질을 지나치게 해치는 일방적인 선택을 피하도록 도와줍니다.
text-embedding-3-small은 낮은 차원에서 다국어 검색에 적합한가요?#
작동할 수는 있지만, 다국어 검색은 단일 언어 검색보다 더 엄격한 테스트가 필요합니다. 낮은 차원은 특히 짧은 쿼리와 혼합 스크립트에서 언어 간 미묘한 의미를 합쳐버릴 수 있습니다. 512 또는 1024에서 시작한 뒤, 언어 쌍, 쿼리 길이, 도메인 용어별로 테스트하세요. text-embedding-3-small 차원 설명에서 다국어 설정은 정밀도가 중요할 때 더 큰 차원에서 이점을 얻는 경우가 많습니다. 각 핵심 언어 세그먼트의 관련성 목표를 여전히 충족하는 가장 작은 설정을 선택하세요.
핵심은 text-embedding-3-small 차원이 실용적인 튜닝 레버라는 점입니다. 높은 차원은 의미 충실도를 높일 수 있고, 낮은 차원은 스토리지, 지연 시간, 비용을 줄이므로 올바른 선택은 검색 품질 목표와 시스템 제약에 따라 달라집니다. 차원 크기는 기본값에 의존하지 말고, 자체 데이터에서 재현율, 랭킹 품질, 엔드투엔드 성능을 벤치마크해 실증적으로 결정하세요. 이번 주에 자체 파이프라인에서 여러 차원을 테스트한 뒤, 추측이 아니라 근거로 프로덕션 설정을 고정하세요.
Implementation Guides
Available in other languages: