 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
text-embedding-3-small Dimensi Dijelaskan: Cara Memilih Ukuran yang Tepat untuk Kualitas dan Biaya
Panduan praktis tentang dimensi text-embedding-3-small, cara memilih antara 256, 512, 1024, dan 1536 dimensi.
text-embedding-3-small Dimensi Dijelaskan: Cara Memilih Ukuran yang Tepat untuk Kualitas dan Biaya#
Pada 1536 dimensi, satu vektor text-embedding-3-small yang disimpan sebagai float32 memakai 6,144 byte, sehingga 10 juta vektor membutuhkan sekitar 61 GB sebelum overhead indeks. Angka ini sering mengejutkan tim ketika retrieval terasa murah pada skala kecil, lalu tagihan memori naik dan waktu kueri bertambah setelah korpus berkembang. Bagian sulitnya adalah dimensi yang lebih tinggi dapat meningkatkan ranking pada satu dataset, tetapi pengaturan yang sama bisa memboroskan storage dan menambah latensi pada dataset lain.
Itulah inti dari text-embedding-3-small Dimensi Dijelaskan: tidak ada pengaturan universal yang menang di setiap workload. Anda perlu memilih ukuran dimensi dengan menguji target relevansi, batas latensi p95, dan anggaran penyimpanan vektor Anda secara bersamaan, bukan satu per satu. Jika Anda hanya mengoptimalkan kualitas, biaya cepat naik. Jika Anda hanya mengecilkan ukuran, kualitas pencarian dapat turun dengan cara yang terasa oleh pengguna.
Anda akan melihat metode pemilihan yang praktis: buat eval set kecil, bandingkan relevansi pada dua atau tiga ukuran dimensi, ukur waktu respons end-to-end, dan ubah jumlah dimensi menjadi biaya storage nyata per juta vektor. Dari sana, ukuran yang tepat menjadi keputusan engineering yang terukur, bukan tebakan.
Apa Arti "Dimensi" dalam text-embedding-3-small (dan Mengapa Ini Mengubah Hasil)#
Secara sederhana, text-embedding-3-small Dimensi Dijelaskan berarti satu hal: seberapa banyak makna yang Anda simpan di setiap vektor. Jumlah dimensi adalah kenop kompresi, bukan sakelar kualitas. text-embedding-3-small memiliki ukuran maksimum 1536 dimensi (dari spesifikasi model di knowledge base). Ukuran yang lebih rendah melakukan kompresi lebih kuat.
text-embedding-3-small dimensi dijelaskan: makna semantik menjadi vektor numerik#
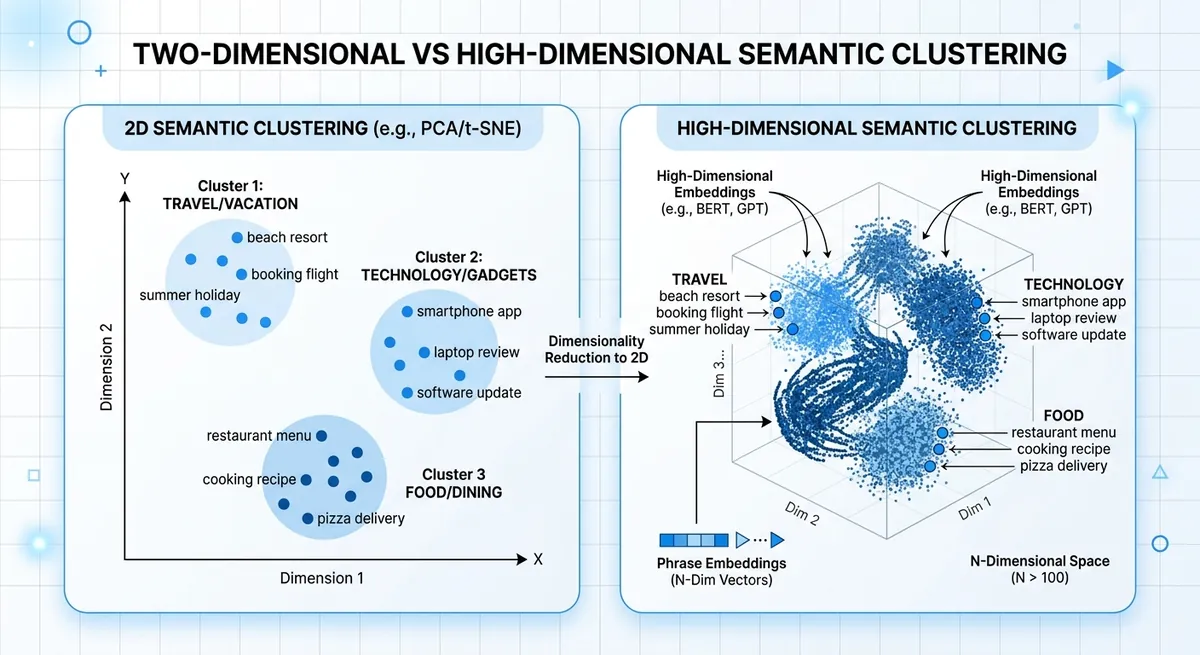
Embedding mengubah teks menjadi angka agar frasa yang mirip berada dekat satu sama lain dalam ruang vektor. "Reset my password" dan "I cannot sign in" seharusnya berada dekat. Setiap dimensi tambahan memberi model lebih banyak ruang untuk menyimpan nuansa seperti intent, tone, atau istilah domain. Jika Anda mengecilkan vektor, Anda mempertahankan makna inti tetapi membuang detail yang lebih halus.
ukuran dimensi text-embedding-3-small dan perubahan kualitas ranking#
Dimensi yang lebih rendah dapat mempercepat pencarian dan memangkas storage, tetapi ranking nearest-neighbor dapat bergeser. Pergeseran itu muncul ketika dua intent terlihat mirip di permukaan tetapi berbeda dalam tindakan, seperti "cancel plan" vs "pause plan."
| Pilihan ukuran vektor | Fidelitas semantik | Kecepatan runtime | Storage per 1M vektor (float32) |
|---|---|---|---|
| 1536 (text-embedding-3-small penuh) | Retensi detail tertinggi | Lebih lambat daripada vektor yang lebih kecil | ~6.1 GB |
| 768 (terkompresi) | Ada kehilangan sebagian detail | Lebih cepat | ~3.1 GB |
| 512 (terkompresi) | Risiko kehilangan lebih besar pada intent yang berdekatan | Lebih cepat lagi | ~2.0 GB |
Sumber: dimensi maksimum text-embedding-3-small dari knowledge base yang disediakan; perhitungan storage dari dimensi × 4 byte.
Itulah inti praktis dari text-embedding-3-small Dimensi Dijelaskan: tuning dimensi dengan uji relevansi, latensi p95, dan storage vektor secara bersamaan.
Opsi Dimensi text-embedding-3-small: Rentang Praktis dan Tradeoff#
Untuk text-embedding-3-small, ukuran vektor native adalah 1536 dimensi. Dalam sistem nyata, tim sering memendekkan vektor untuk memangkas RAM, disk, dan beban indeks ANN. Storage bertambah secara linear mengikuti jumlah dimensi, jadi setiap pilihan ukuran adalah keputusan biaya dan latensi langsung. Ini adalah inti praktis dari text-embedding-3-small Dimensi Dijelaskan.
text-embedding-3-small Dimensi Dijelaskan: pengaturan umum dan use case yang paling cocok#
Jika Anda membutuhkan default kasar, tabel ini adalah peta awal yang baik untuk A/B test.
| Dimensi | Raw storage per 1M vektor (float32) | Paling cocok | Risiko umum |
|---|---|---|---|
| 256 | ~0.95 GB | Batas latensi atau anggaran ketat, pencocokan intent sederhana | Lebih banyak miss pada kueri bernuansa |
| 384 | ~1.43 GB | Pencarian semantik berorientasi biaya dengan teks pendek | Recall lebih rendah pada edge case |
| 512 | ~1.91 GB | Pencarian seimbang untuk dokumen support, bantuan produk, FAQ | Sebagian makna long-tail hilang |
| 768 | ~2.86 GB | Retrieval balanced-plus, gaya kueri campuran | Pertumbuhan biaya infra moderat |
| 1024 | ~3.81 GB | RAG high-recall atas dokumen padat | Memori indeks dan waktu kueri lebih tinggi |
| 1536 | ~5.72 GB | Retrieval fidelitas penuh, similarity bernuansa | Tekanan storage dan latensi tertinggi |
Sumber: rentang dimensi dari outline dan info model yang disediakan (text-embedding-3-small = 1536). Storage dihitung sebagai dimensi × 4 byte × 1,000,000 vektor.
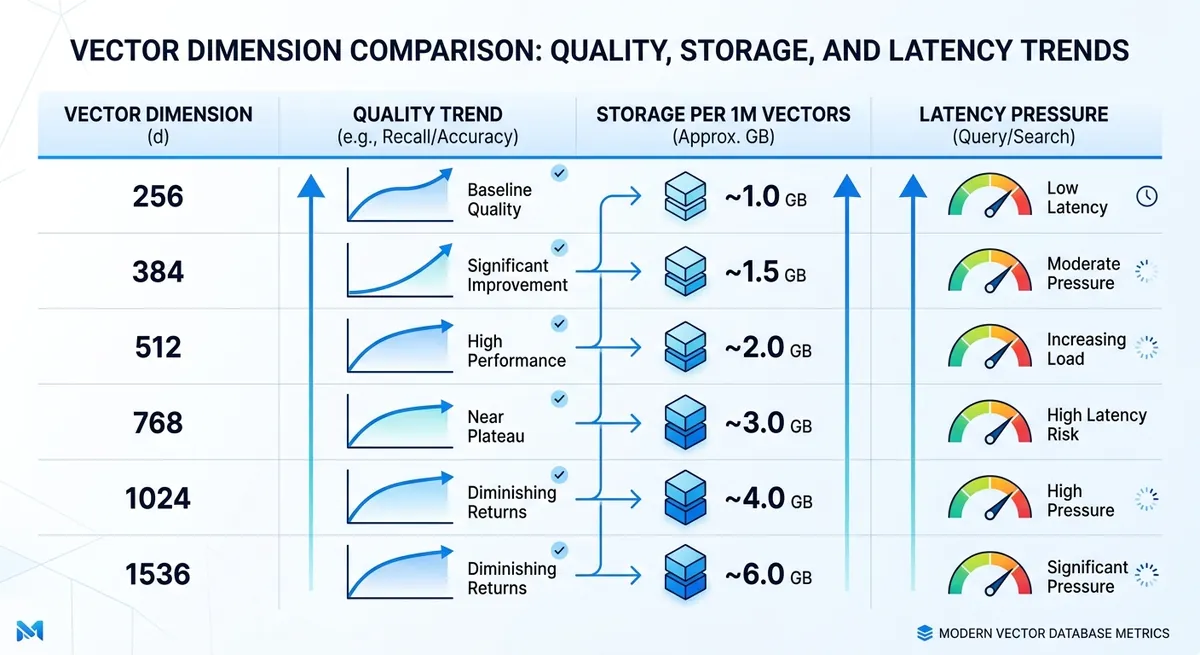
tradeoff kualitas text-embedding-3-small: di mana degradasi mulai muncul#
Kehilangan kualitas biasanya muncul lebih awal pada tugas yang sangat bergantung pada presisi. Retrieval FAQ bisa tetap layak dipakai pada 384 atau 512, sementara pencarian legal atau medis sering membutuhkan 1024 atau 1536 untuk mempertahankan perbedaan makna yang halus.
Campuran bahasa juga mengubah batas aman terendah. Workload bahasa Inggris monolingual dapat bertahan pada ukuran lebih rendah. Traffic multilingual, code-switching, dan skrip campuran cenderung lebih cepat terdegradasi ketika vektor dipendekkan.
Anda dapat menjalankan tes ini dengan cepat melalui Crazyrouter menggunakan satu API key dan membandingkan kualitas retrieval pada 512, 768, dan 1536 di eval set yang sama. Ini memberi titik cutoff yang terukur, bukan tebakan.
Kualitas, Latensi, dan Biaya: Benchmark Tiga Arah yang Benar-benar Anda Butuhkan#
Anda sudah melihat mengapa satu metrik bisa menyesatkan. Untuk text-embedding-3-small Dimensi Dijelaskan, langkah praktisnya adalah menguji satu target relevansi, satu anggaran latensi, dan satu anggaran storage pada saat yang sama. Pilih dimensi terkecil yang tetap melewati standar kualitas Anda di bawah batas latensi p95.
test set dimensi text-embedding-3-small: bangun relevansi offline yang bisa Anda percaya#
Gunakan log pencarian nyata, tiket support, dan prompt chat. Buat 200–500 contoh kueri jika memungkinkan. Ukuran itu cukup untuk mengekspos titik lemah tanpa memperlambat tim Anda.
Beri label apa arti "baik" untuk setiap kueri. Pertahankan label sederhana: relevan, sebagian relevan, tidak relevan. Tambahkan kasus sulit dengan sengaja: kueri pendek, kueri dengan typo, istilah domain, dan kueri multilingual. Jika aplikasi Anda melayani campuran bahasa, masukkan kueri campuran bahasa dalam set yang sama.
Jangan biarkan hanya satu orang memberi label hasil. Dua reviewer mengurangi bias dengan cepat.
metrik benchmark dimensi text-embedding-3-small: kualitas dan latensi bersamaan#
Lacak kualitas ranking dan kecepatan dalam satu run. Recall@k memberi tahu apakah item yang benar muncul di top-k. MRR dan nDCG memberi tahu apakah item itu muncul dekat bagian atas, tempat pengguna mengklik.
Untuk latensi, pisahkan jalurnya: waktu embedding dan waktu retrieval. Pantau p95 dan p99, bukan hanya latensi rata-rata. Request lambat di tail membentuk pengalaman pengguna.
| Kandidat dimensi | Ukuran diketahui per vektor (float32) | Memori indeks relatif | Metrik kualitas yang dilacak | Metrik latensi yang dilacak |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| Kandidat dimensi lebih rendah di stack Anda | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
Sumber: dimensi model dari daftar model Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072). Perhitungan byte menggunakan vektor float32.
model biaya dimensi text-embedding-3-small: dari storage ke dampak bisnis#
Ubah dimensi menjadi uang sebelum rollout.
Storage per juta vektor = dimension × 4 bytes × 1,000,000, lalu kalikan dengan jumlah replika. Tambahkan overhead indeks dari database vektor Anda.
Sekarang hubungkan peningkatan kualitas ke sinyal bisnis yang sudah Anda lacak, seperti CTR, ticket deflection, atau conversion. Jika dimensi yang lebih besar menaikkan nDCG sedikit tetapi menggandakan memori dan gagal memenuhi p95, pertahankan pengaturan yang lebih kecil. Jika itu meningkatkan relevansi ranking cukup besar untuk menggerakkan conversion, Anda memiliki business case yang jelas.
Cara Memilih Dimensi yang Tepat Berdasarkan Use Case#
Jika Anda masih menebak ukuran dimensi, bagian text-embedding-3-small Dimensi Dijelaskan ini adalah jalan pintasnya: petakan dimensi ke workload, lalu verifikasi dengan eval set kecil sebelum rollout.
text-embedding-3-small Dimensi Dijelaskan untuk RAG dan enterprise search#
RAG dan pencarian internal cepat gagal ketika recall turun. Pengguna mengajukan satu pertanyaan, lalu pergi jika hasil teratas melewatkan fakta kunci. Jadi titik awal Anda seharusnya kualitas, bukan storage.
Gunakan 1536 sebagai baseline untuk text-embedding-3-small, lalu uji satu ukuran lebih rendah hanya setelah Anda mengonfirmasi recall pada kueri sulit. Kueri sulit berarti pertanyaan panjang, istilah langka, dan intent campuran.
Chunking mengubah hasil lebih besar daripada yang sering diperkirakan. Chunk kecil plus dimensi rendah dapat kehilangan konteks dua kali: sekali saat pemisahan, sekali saat embedding. Jika chunk Anda pendek, pertahankan dimensi lebih tinggi. Jika chunk Anda panjang dan bersih, Anda dapat menguji ukuran lebih rendah tanpa risiko buta.
dimensi text-embedding-3-small untuk rekomendasi, clustering, dan semantic routing#
Sistem ini biasanya lebih peduli pada kecepatan dan grouping yang stabil, bukan recall top-1 yang sempurna. Pengaturan menengah sering memberi tradeoff terbaik.
Untuk routing, similarity perkiraan sering sudah cukup karena model tahap kedua dapat melakukan re-rank atau verifikasi. Artinya Anda dapat menguji dimensi lebih rendah lebih awal daripada pada RAG. Untuk clustering, nilai kemurnian cluster dan drift pada data mingguan, bukan hanya satu run offline.
Pilih dimensi terkecil yang tetap menjaga metrik downstream Anda stabil selama dua siklus traffic penuh.
text-embedding-3-small Dimensi Dijelaskan untuk workload multilingual dan domain-specific#
Bahasa domain mengubah permainan. Istilah legal, medis, atau hardware dapat terlihat dekat dalam bahasa umum tetapi jauh dalam makna. Dimensi lebih rendah dapat mengaburkan batas-batas ini.
Traffic multilingual membutuhkan pemeriksaan per bahasa. Jangan rata-ratakan semuanya menjadi satu skor. Jalankan set intent yang sama di setiap segmen bahasa utama, lalu bandingkan pola miss. Ukuran yang berhasil di bahasa Inggris dapat gagal pada kueri campuran bahasa atau istilah transliterasi.
| Use case | Dimensi awal yang direkomendasikan | Yang harus diukur sebelum menurunkan | Tanda kegagalan umum |
|---|---|---|---|
| RAG / enterprise search | 1536 | Recall pada kueri sulit, grounding jawaban | Dokumen yang benar tidak ada di hasil teratas |
| Rekomendasi | Menengah (uji di bawah 1536) | Stabilitas CTR atau conversion | Item yang mirip tetapi tidak relevan naik |
| Semantic routing | Menengah ke lebih rendah | Akurasi route + fallback rate | Route salah, fallback lebih tinggi |
| Multilingual / domain-heavy | 1536 | Recall per bahasa, error tingkat istilah | Istilah langka dipetakan ke makna generik |
Sumber: info dimensi model dari daftar model Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072).
<!-- IMAGE: Matriks keputusan berdasarkan use case (RAG, recsys, routing, multilingual) dengan dimensi awal yang direkomendasikan. -->Panduan Implementasi: API, Skema Vektor, dan Langkah Migrasi#
dimensi text-embedding-3-small dijelaskan dalam request API#
Baseline aman untuk text-embedding-3-small adalah 1536 dimensi. Anda dapat meminta ukuran yang lebih kecil dengan field dimensions, tetapi pertahankan ukuran itu tetap per indeks. Jika vektor dokumen memakai 1024 dan vektor kueri memakai 1536, kualitas retrieval akan drift meskipun kedua call berhasil.
Gunakan satu nilai config untuk jalur write dan read, lalu validasi pada setiap request: teks input tidak kosong, panjang vektor sama dengan dimensi yang dikonfigurasi, dan setiap nilai adalah angka nyata (tanpa NaN, tanpa Inf). Jika validasi gagal, arahkan item ke retry queue dan lakukan re-embed dengan ukuran default Anda.
Anda dapat menggunakan OpenAI SDK dengan endpoint kompatibel seperti https://crazyrouter.com/v1, lalu pin model dan dimensi dalam satu file config bersama yang digunakan oleh semua service.
kontrol dimensi text-embedding-3-small dalam skema vektor dan desain indeks#
Pertahankan satu dimensi per indeks, dan pertahankan vektor kueri dan dokumen pada ukuran yang sama.
Gunakan nama collection yang mengunci dimensi seperti kb_d1536_v1 dan kb_d1024_v1. Penamaan ini membuat migrasi mudah dibaca dan mencegah pencampuran diam-diam.
Ketika dimensionality berubah, rebuild pengaturan indeks dengan vektor baru. Untuk HNSW, tuning ulang pengaturan graph dan search setelah rebuild. Untuk IVF, latih ulang centroid pada vektor dari ukuran dimensi baru. Menggunakan ulang data training indeks lama dapat merusak recall.
dimensi text-embedding-3-small dijelaskan untuk migrasi dari model lama#
Jalankan migrasi dalam fase:
| Fase | Jalur write | Jalur read | Yang harus diperiksa |
|---|---|---|---|
| Dual-write | Old + new embeddings | Old index | Tingkat keberhasilan write dan error validasi vektor |
| Shadow-read | Old + new embeddings | Pengguna melihat old, log new | Overlap top-k, latensi, kasus kueri buruk |
| Cutover | Old + new embeddings | New index | Tingkat kelulusan relevansi dan target latensi p95 |
| Rollback | Pertahankan dual-write aktif | Beralih kembali ke old | Trigger pada lonjakan error atau penurunan relevansi |
Sumber: knowledge base Crazyrouter (text-embedding-3-small pada 1536 dimensi; API kompatibel OpenAI; 300+ model yang didukung).
Ini adalah inti praktis dari text-embedding-3-small Dimensi Dijelaskan: kunci dimensi, uji dengan shadow traffic, dan cut over hanya setelah paritas terukur.
Operasi Produksi: Memantau Drift, Regresi Kualitas, dan Workflow Tim#
Anda memilih ukuran dimensi dengan pengujian offline. Awal yang baik. Risiko nyata muncul kemudian, setelah konten baru, campuran kueri baru, dan pergeseran ranking masuk ke produksi. Dalam text-embedding-3-small Dimensi Dijelaskan, kualitas jangka panjang berasal dari loop yang ketat: data eval tetap, pemeriksaan perilaku live, dan langkah rollout yang terkendali.
Siapkan monitoring drift dimensi text-embedding-3-small#
Kunci eval set dan metrik Anda sebelum setiap perubahan dimensi. Pertahankan golden query set yang cocok dengan intent pengguna nyata, lalu beri skor setiap minggu dengan rubrik yang sama. Pasangkan itu dengan sinyal live agar Anda menangkap drift lebih awal, bukan setelah tiket support menumpuk.
| Sinyal | Seperti apa drift terlihat | Frekuensi review | Trigger tindakan |
|---|---|---|---|
| Skor relevansi golden set | Hasil teratas berhenti cocok dengan jawaban known-good | Scorecard mingguan | Turun vs run stabil terakhir |
| CTR pada blok retrieval | Pengguna lebih jarang mengklik dokumen yang disarankan | Harian | Penurunan berkelanjutan |
| Tingkat keberhasilan tugas | Lebih banyak sesi gagal menyelesaikan tugas target | Harian | Tren turun per segmen |
| No-result rate | Respons retrieval kosong meningkat | Harian | Lonjakan setelah deploy |
Sumber tabel: pola runbook operasional yang digunakan di bagian ini (golden set + metrik online dari outline yang disediakan).
<!-- IMAGE: mock dashboard yang menunjukkan skor golden-set mingguan, tren CTR, no-result rate, dan threshold alert -->Jalankan eksperimen dimensi text-embedding-3-small dengan aman di staging dan produksi#
Mulai di staging dengan kueri replay dari 7 hingga 14 hari terakhir. Pindah ke produksi dengan canary slice, lalu perluas berdasarkan segmen pengguna dan region. Siapkan rollback. Jika kualitas turun, hentikan pertumbuhan traffic, beralih ke dimensi stabil terakhir, dan catat jenis kueri yang gagal. Ini menjaga insiden tetap singkat dan memberi data bersih untuk tes berikutnya.
Workflow tim untuk eksperimen text-embedding-3-small Dimensi Dijelaskan#
Evaluasi lintas tim sering rusak karena orang menguji dalam sesi browser yang bercampur. SEO, product, dan ML dapat saling menimpa state, lalu tidak ada yang mempercayai hasilnya. Anda dapat menggunakan profil terisolasi DICloak agar setiap role menguji build yang sama tanpa konflik sesi atau account crossover.
Tool seperti DICloak memungkinkan Anda menetapkan aturan proxy dan sesi tetap per profil. Artinya pengujian "US-English account" dan "EU account" berjalan dalam kondisi jaringan yang stabil setiap kali. Setup yang reproducible membuat pemeriksaan ranking berbasis dimensi lebih mudah dibandingkan antar rekan tim, dan memberi Anda jalur yang repeatable dan aman untuk pekerjaan text-embedding-3-small Dimensi Dijelaskan yang berkelanjutan.
Kesalahan Umum dan Checklist Akhir Pemilihan Dimensi#
Jika Anda membaca sampai sejauh ini, text-embedding-3-small Dimensi Dijelaskan seharusnya berakhir pada keputusan launch, bukan tebakan.
kesalahan dimensi text-embedding-3-small yang merusak produksi#
| Kesalahan | Apa yang salah | Yang harus dilakukan |
|---|---|---|
| Anda hanya mempercayai skor benchmark vendor | Pencarian terlihat baik dalam tes, tetapi kueri nyata Anda gagal menangkap intent | Bangun eval set internal dari kueri pengguna nyata, lalu beri skor setiap pengaturan dimensi pada set itu |
| Anda memangkas biaya storage dan melewati pemeriksaan kualitas | Ukuran vektor lebih rendah menghemat uang, tetapi kualitas klik turun dan tiket support naik | Lacak kualitas retrieval dan perilaku pengguna bersama sebelum rollout |
| Anda hanya menguji relevansi | Pengaturan indeks yang cepat masih bisa gagal memenuhi target p95 Anda | Ukur latensi end-to-end: embed + index search + rerank |
Checklist 10 poin akhir untuk go-live text-embedding-3-small Dimensi Dijelaskan#
- Bersihkan duplikat dan teks rusak pada data sumber.
- Cakup kueri head, mid, dan tail dalam benchmark Anda.
- Bandingkan setidaknya dua ukuran: 1536 (text-embedding-3-small) dan 3072 (text-embedding-3-large).
- Catat relevansi top-k untuk setiap ukuran pada set kueri yang sama.
- Catat latensi p95 dari API call hingga hasil ranking akhir.
- Ubah jumlah dimensi menjadi biaya storage per juta vektor.
- Jalankan canary dengan traffic nyata dan metrik keberhasilan.
- Siapkan langkah rollback sebelum rollout penuh.
- Tetapkan satu owner untuk monitoring dan respons alert.
- Tetapkan cadence review retraining atau re-embedding.
Ship hanya ketika relevansi, latensi p95, dan biaya storage lulus bersama.
<!-- IMAGE: Grafik checklist launch satu halaman untuk keputusan dimensi embedding. -->Pertanyaan yang sering diajukan#
Dalam text-embedding-3-small Dimensi Dijelaskan, apa dimensi default terbaik untuk memulai?#
Titik awal praktis adalah 512 untuk sebagian besar tim, atau 1024 jika konten Anda kompleks (legal, teknis, dokumen long-form). Dalam text-embedding-3-small Dimensi Dijelaskan, ini memberi keseimbangan kuat antara kualitas, kecepatan, dan biaya tanpa terlalu berkomitmen sejak awal. Lalu jalankan benchmark kecil menggunakan kueri pengguna nyata dan filter yang diharapkan. Pilih dimensi terkecil yang tetap memenuhi target relevansi Anda, bukan hanya yang terlihat terbaik dalam tes mainan.
Apakah menurunkan dimensi dalam text-embedding-3-small Dimensi Dijelaskan selalu mengurangi kualitas retrieval?#
Dimensi lebih rendah tidak selalu merusak hasil secara bermakna. Untuk pencarian FAQ pendek atau domain sempit, penurunannya bisa kecil. Untuk katalog luas, konten multilingual, atau pencocokan semantik bernuansa, kualitas dapat turun lebih cepat. Dalam text-embedding-3-small Dimensi Dijelaskan, perlakukan dimensi sebagai kenop tuning: bandingkan 256, 512, dan 1024 pada set kueri yang sama. Pertahankan ukuran terkecil yang menjaga Recall@k dan kualitas ranking yang dapat diterima untuk pengguna nyata Anda.
Bagaimana dimensi text-embedding-3-small memengaruhi biaya database vektor?#
Biaya meningkat kurang lebih secara linear mengikuti jumlah dimensi. Jika Anda memangkas vektor dari 1024 ke 512, raw vector storage kira-kira menjadi setengah. Tren yang sama berlaku untuk penggunaan RAM dan sering juga compute kueri. Tetapi sertakan overhead indeks: struktur ANN menambah memori untuk graph links, metadata, dan bookkeeping internal. Jadi penghematan total kuat, tetapi bukan hanya byte vektor. Dalam praktiknya, estimasikan ukuran indeks penuh, bukan hanya ukuran embedding, sebelum Anda menetapkan dimensi akhir.
Apakah saya perlu melakukan re-embed semua dokumen saat mengubah dimensi?#
Ya. Vektor yang dibuat pada satu dimensi tidak dapat dicampur dengan vektor dari dimensi lain dalam satu indeks yang konsisten. Saat Anda mengubah dimensi, lakukan re-embed semua dokumen dan rebuild indeks. Untuk sistem produksi, gunakan migrasi yang lebih aman: jalankan rollout dual-index. Bangun indeks baru secara paralel, kirim sebagian traffic ke sana, bandingkan kualitas dan latensi, lalu beralih sepenuhnya. Ini menghindari downtime dan menjaga perilaku pencarian tetap stabil selama transisi.
Metrik apa yang harus saya lacak saat membandingkan dimensi?#
Lacak tiga kelompok: relevansi, kecepatan, dan biaya. Untuk relevansi, gunakan Recall@k, nDCG, dan MRR pada set kueri berlabel. Untuk kecepatan, pantau latensi p50/p95/p99, karena tail latency memengaruhi pengalaman pengguna. Untuk biaya, ukur storage per juta dokumen, footprint RAM, dan biaya per 1,000 kueri. Dalam text-embedding-3-small Dimensi Dijelaskan, scorecard ini membantu Anda menghindari pilihan sepihak ketika Anda menghemat storage tetapi terlalu merusak kualitas ranking.
Apakah text-embedding-3-small cocok untuk pencarian multilingual pada dimensi lebih rendah?#
Bisa berfungsi, tetapi pencarian multilingual membutuhkan pengujian yang lebih ketat daripada pencarian satu bahasa. Dimensi lebih rendah dapat menggabungkan makna halus lintas bahasa, terutama untuk kueri pendek dan skrip campuran. Mulai dari 512 atau 1024, lalu uji berdasarkan pasangan bahasa, panjang kueri, dan istilah domain. Dalam text-embedding-3-small Dimensi Dijelaskan, setup multilingual sering mendapat manfaat dari dimensi lebih besar ketika presisi penting. Pilih pengaturan terkecil yang tetap memenuhi target relevansi untuk setiap segmen bahasa utama.
Inti utamanya adalah bahwa dimensi text-embedding-3-small adalah tuas tuning praktis: dimensi lebih tinggi dapat meningkatkan fidelitas semantik, sementara dimensi lebih rendah mengurangi storage, latensi, dan biaya, sehingga pilihan yang tepat bergantung pada target kualitas retrieval dan batasan sistem Anda. Perlakukan ukuran dimensi sebagai keputusan empiris dengan membenchmark recall, kualitas ranking, dan performa end-to-end pada data Anda sendiri, bukan mengandalkan default. Uji beberapa dimensi di pipeline Anda sendiri minggu ini, lalu kunci pengaturan produksi Anda dengan bukti, bukan tebakan.
Implementation Guides
Available in other languages: