 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
text-embedding-3-small の次元数の説明:品質とコストのバランスを取る適切なサイズの選び方
text-embedding-3-small の次元数に関する実践的なガイド。256、512、1024、1536 の次元数の選択方法について説明します。
text-embedding-3-small の次元数の説明:品質とコストのバランスを取る適切なサイズの選び方#
1536 次元の場合、float32 として保存される text-embedding-3-small の 1 ベクトルは 6,144 bytes を使用するため、1,000 万ベクトルではインデックスのオーバーヘッドを除いて約 61 GB が必要になります。小規模では検索が安価に見えても、コーパスが拡大するとメモリ費用が増え、クエリ時間も伸びるため、この数字に驚くチームは少なくありません。難しいのは、次元数を上げるとあるデータセットではランキングが改善する一方、別のデータセットではストレージを浪費し、レイテンシを増やすだけになる場合があることです。
これが text-embedding-3-small Dimensions Explained の核心です。あらゆるワークロードで常に勝つ万能設定はありません。次元サイズは、自分たちの関連性目標、p95 レイテンシ上限、ベクトルストレージ予算を個別ではなくまとめてテストして選ぶ必要があります。品質だけを最適化すると、コストは急速に増えます。サイズ削減だけを優先すると、ユーザーが気づく形で検索品質が低下する可能性があります。
ここでは実践的な選定方法を示します。小さな評価セットを作り、2 つまたは 3 つの次元サイズで関連性を比較し、エンドツーエンドの応答時間を測定し、次元数を 100 万ベクトルあたりの実ストレージコストに換算します。そこから適切なサイズは、勘ではなく測定可能なエンジニアリング判断になります。
text-embedding-3-small における「次元」とは何か(そして結果が変わる理由)#
平たく言えば、text-embedding-3-small Dimensions Explained が意味することは 1 つです。各ベクトルにどれだけの意味を保持するか、ということです。次元数は圧縮のつまみであり、品質のオン・オフスイッチではありません。 text-embedding-3-small の最大サイズは 1536 次元です(ナレッジベースのモデル仕様より)。より低いサイズでは、より強く圧縮されます。
text-embedding-3-small の次元数の説明:意味情報から数値ベクトルへ#
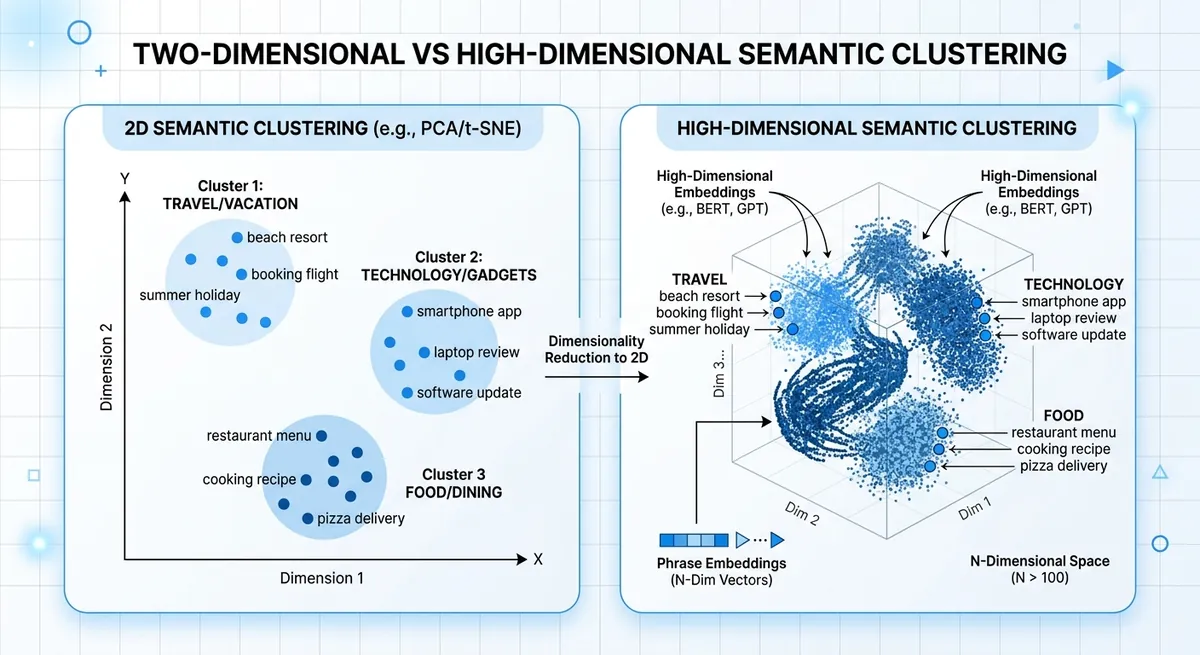
埋め込みはテキストを数値に変換し、似たフレーズがベクトル空間内で近くに位置するようにします。 "Reset my password" と "I cannot sign in" は近くに配置されるべきです。 次元が 1 つ増えるごとに、モデルは意図、トーン、ドメイン用語のようなニュアンスを保存する余地を得ます。 ベクトルを縮小すると、中心的な意味は保持されますが、細かな詳細は失われます。
text-embedding-3-small の次元サイズとランキング品質の変化#
低次元にすると検索を高速化し、ストレージを削減できますが、近傍探索のランキングは変化する可能性があります。 その変化は、"cancel plan" と "pause plan" のように、表面的には似ているものの実行すべきアクションが異なる 2 つの意図で表れます。
| ベクトルサイズの選択 | 意味の忠実度 | 実行時速度 | 1M ベクトルあたりのストレージ(float32) |
|---|---|---|---|
| 1536(完全な text-embedding-3-small) | 最も高い詳細保持 | 小さいベクトルより遅い | ~6.1 GB |
| 768(圧縮) | 一部の詳細が失われる | より高速 | ~3.1 GB |
| 512(圧縮) | 近い意図で損失リスクが高い | さらに高速 | ~2.0 GB |
出典:text-embedding-3-small の最大次元は提供されたナレッジベースより。ストレージ計算は dimensions × 4 bytes に基づく。
これが text-embedding-3-small Dimensions Explained の実践的な核心です。関連性テスト、p95 レイテンシ、ベクトルストレージをまとめて見ながら次元数を調整します。
text-embedding-3-small の次元オプション:実用的な範囲とトレードオフ#
text-embedding-3-small のネイティブなベクトルサイズは 1536 次元です。実システムでは、RAM、ディスク、ANN インデックス負荷を下げるために、チームがベクトルを短くすることがよくあります。ストレージは次元数に対して線形に増えるため、各サイズ選択はコストとレイテンシの直接的な選択です。 これが text-embedding-3-small Dimensions Explained の実践的な核心です。
text-embedding-3-small Dimensions Explained:一般的な設定と適したユースケース#
大まかなデフォルトが必要な場合、この表は A/B テストの出発点として有用です。
| 次元 | 1M ベクトルあたりの生ストレージ(float32) | 最適な用途 | 典型的なリスク |
|---|---|---|---|
| 256 | ~0.95 GB | 厳しいレイテンシまたは予算制約、シンプルな意図マッチング | ニュアンスのあるクエリで取りこぼしが増える |
| 384 | ~1.43 GB | 短文向けのコスト重視の意味検索 | エッジケースで recall が低下する |
| 512 | ~1.91 GB | サポート文書、製品ヘルプ、FAQ 向けのバランス型検索 | ロングテールの意味が一部失われる |
| 768 | ~2.86 GB | バランス重視より少し高品質な検索、混在するクエリスタイル | インフラコストが中程度に増える |
| 1024 | ~3.81 GB | 密度の高い文書に対する高 recall の RAG | インデックスメモリとクエリ時間が増える |
| 1536 | ~5.72 GB | 完全な忠実度の検索、ニュアンスのある類似性 | ストレージとレイテンシへの圧力が最も高い |
出典:次元範囲は提供されたアウトラインとモデル情報(text-embedding-3-small = 1536)より。ストレージは dimensions × 4 bytes × 1,000,000 vectors として計算。
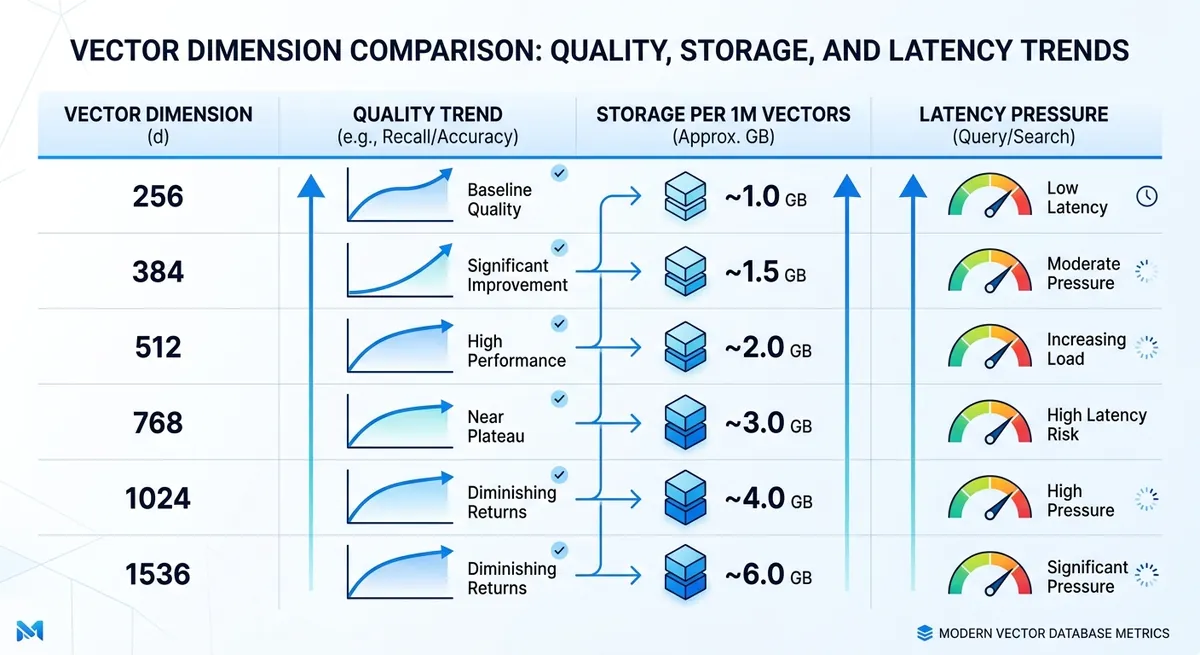
text-embedding-3-small の品質トレードオフ:劣化が始まる場所#
品質低下は通常、精度重視のタスクで早く表れます。FAQ 検索は 384 または 512 でも実用的なままの場合がありますが、法務や医療の検索では、微細な意味の違いを保つために 1024 または 1536 が必要になることがよくあります。
言語の組み合わせも安全な下限を変えます。英語のみの単一言語ワークロードは低いサイズでも持ちこたえやすいです。多言語トラフィック、コードスイッチング、混在スクリプトでは、ベクトルが短くなると劣化が早くなりがちです。
Crazyrouter を使えば、1 つの API key でこのテストをすばやく実行し、同じ評価セット上で 512、768、1536 の検索品質を比較できます。これにより、勘ではなく測定可能なカットオフポイントが得られます。
品質、レイテンシ、コスト:本当に必要な三者ベンチマーク#
1 つの指標だけでは判断を誤る理由はすでに見ました。 text-embedding-3-small Dimensions Explained における実践的な動きは、1 つの関連性目標、1 つのレイテンシ予算、1 つのストレージ予算を同時にテストすることです。p95 レイテンシ上限の下で品質基準を満たす最小の次元を選びます。
text-embedding-3-small の次元テストセット:信頼できるオフライン関連性を作る#
実際の検索ログ、サポートチケット、チャットプロンプトを使います。可能であれば 200〜500 件のクエリ例を作成してください。この規模なら、チームの動きを遅くしすぎずに弱点を明らかにできます。
各クエリについて「良い」とは何かをラベル付けします。ラベルはシンプルに保ちます:関連あり、部分的に関連あり、関連なし。 短いクエリ、タイプミスのあるクエリ、ドメイン用語、多言語クエリなどの難しいケースを意図的に追加します。アプリが複数言語に対応している場合は、同じセットに混在言語クエリを含めます。
結果のラベル付けを 1 人だけに任せないでください。2 人のレビュアーにすることで、バイアスを素早く減らせます。
text-embedding-3-small の次元ベンチマーク指標:品質とレイテンシを一緒に見る#
ランキング品質と速度を 1 回の実行で追跡します。 Recall@k は、正しい項目が top-k に出てくるかを示します。MRR と nDCG は、それがユーザーのクリックしやすい上位に現れるかを示します。
レイテンシについては、経路を分けます:埋め込み時間と検索時間です。平均レイテンシだけでなく、p95 と p99 を見てください。遅いテールリクエストがユーザー体験を形作ります。
| 次元候補 | 1 ベクトルあたりの既知サイズ(float32) | 相対インデックスメモリ | 追跡する品質指標 | 追跡するレイテンシ指標 |
|---|---|---|---|---|
| 1536(text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072(text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 自分のスタック内の低次元候補 | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
出典:モデル次元は Crazyrouter モデルリスト(text-embedding-3-small: 1536, text-embedding-3-large: 3072)より。バイト計算は float32 ベクトルを使用。
text-embedding-3-small の次元コストモデル:ストレージからビジネス影響へ#
ロールアウト前に次元を金額へ換算します。
100 万ベクトルあたりのストレージ = dimension × 4 bytes × 1,000,000、その後レプリカ数を掛けます。ベクトルデータベースのインデックスオーバーヘッドも加えます。
<.-- IMAGE: 次元とコーパスサイズからベクトルストレージと年間コストを見積もるための数式スタイルのインフォグラフィック。 -->
次に、品質向上を CTR、チケット削減、コンバージョンなど、すでに追跡しているビジネス指標に結び付けます。大きい次元にして nDCG が少し上がっても、メモリが倍になり p95 を満たせないなら、小さい設定を維持します。ランキング関連性が十分に上がり、コンバージョンを動かすなら、明確なビジネス上の根拠があります。
ユースケース別の適切な次元の選び方#
まだ次元サイズを勘で決めているなら、この text-embedding-3-small Dimensions Explained の部分が近道です。ワークロードに次元を対応付け、その後ロールアウト前に小さな評価セットで検証します。
RAG とエンタープライズ検索向けの text-embedding-3-small Dimensions Explained#
RAG と社内検索は、recall が落ちるとすぐに失敗します。ユーザーは 1 つ質問し、上位結果が重要な事実を外すと離脱します。そのため出発点にすべきなのはストレージではなく品質です。
text-embedding-3-small では 1536 をベースラインとして使い、難しいクエリで recall を確認した後にのみ、1 つ低いサイズをテストします。難しいクエリとは、長い質問、まれな用語、混在した意図を意味します。
チャンク分割は、多くの人が想像する以上に結果を変えます。小さいチャンクと低次元を組み合わせると、文脈を 2 回失う可能性があります。1 回は分割で、もう 1 回は埋め込みで失います。チャンクが短い場合は高い次元を維持してください。チャンクが長く整っている場合は、盲目的なリスクを取らずに低いサイズをテストできます。
レコメンデーション、クラスタリング、意味ルーティング向けの text-embedding-3-small 次元#
これらのシステムでは通常、完全な top-1 recall よりも速度と安定したグルーピングが重要です。中程度の設定が最良のトレードオフになることがよくあります。
ルーティングでは、第 2 段階のモデルが再ランキングや検証を行えるため、近似的な類似度で十分な場合が多いです。つまり、RAG よりも早い段階で低次元をテストできます。クラスタリングでは、1 回のオフライン実行だけでなく、週次データにおけるクラスタ純度とドリフトを評価してください。
下流指標が 2 回の完全なトラフィックサイクルにわたって安定する最小の次元を選びます。
多言語およびドメイン特化ワークロード向けの text-embedding-3-small Dimensions Explained#
ドメイン言語は前提を変えます。法務、医療、ハードウェア用語は、通常の言語では近く見えても、意味としては遠い場合があります。低次元では、こうした境界がぼやける可能性があります。
多言語トラフィックでは、言語ごとのチェックが必要です。すべてを 1 つのスコアに平均しないでください。主要な言語セグメントごとに同じ意図セットを実行し、ミスのパターンを比較します。英語で機能するサイズでも、混在言語クエリや音写された用語では失敗することがあります。
| ユースケース | 推奨される開始次元 | 下げる前に測定するもの | よくある失敗の兆候 |
|---|---|---|---|
| RAG / エンタープライズ検索 | 1536 | 難しいクエリでの recall、回答の根拠付け | 正しい文書が上位結果に出ない |
| レコメンデーション | Medium(1536 未満をテスト) | CTR またはコンバージョンの安定性 | 似ているが無関係な項目が上がる |
| 意味ルーティング | Medium to lower | ルート精度 + フォールバック率 | 誤ったルート、フォールバック増加 |
| 多言語 / ドメイン依存度が高い | 1536 | 言語別 recall、用語レベルのエラー | まれな用語が一般的な意味にマッピングされる |
出典:モデル次元情報は Crazyrouter モデルリスト(text-embedding-3-small: 1536, text-embedding-3-large: 3072)より。 <.-- IMAGE: ユースケース別(RAG、recsys、routing、multilingual)の推奨開始次元を示す意思決定マトリクス。 -->
実装ガイド:API、ベクトルスキーマ、移行手順#
API リクエストにおける text-embedding-3-small の次元数の説明#
text-embedding-3-small の安全なベースラインは 1536 次元です。dimensions フィールドでより小さいサイズをリクエストできますが、そのサイズはインデックスごとに固定してください。ドキュメントベクトルが 1024 で、クエリベクトルが 1536 の場合、両方の呼び出しが成功しても検索品質はずれていきます。
書き込み経路と読み取り経路で 1 つの設定値を使い、すべてのリクエストで検証します。入力テキストが空ではないこと、ベクトル長が設定された次元と一致すること、すべての値が実数であること(NaN も Inf もないこと)を確認します。検証に失敗した場合は、その項目をリトライキューに送り、デフォルトサイズで再埋め込みします。
OpenAI SDK を https://crazyrouter.com/v1 のような互換エンドポイントと組み合わせて使い、すべてのサービスで使用する共通設定ファイルにモデルと次元を固定できます。
ベクトルスキーマとインデックス設計における text-embedding-3-small の次元制御#
1 つのインデックスには 1 つの次元を保ち、クエリベクトルとドキュメントベクトルを同じサイズに揃えます。
kb_d1536_v1 や kb_d1024_v1 のように、次元をロックしたコレクション名を使います。この命名により、移行が読みやすくなり、静かな混在を防げます。
<.-- IMAGE: 取り込み、埋め込みサービス、二重ベクトルインデックス、クエリルーターを示すアーキテクチャ図。 -->
次元数が変わるときは、新しいベクトルでインデックス設定を再構築します。HNSW では、再構築後にグラフと検索設定を再調整します。IVF では、新しい次元サイズのベクトルで重心を再学習します。古いインデックス学習データを再利用すると recall が悪化する可能性があります。
旧モデルからの移行における text-embedding-3-small の次元数の説明#
移行は段階的に実行します。
| フェーズ | 書き込み経路 | 読み取り経路 | 確認すること |
|---|---|---|---|
| Dual-write | Old + new embeddings | Old index | 書き込み成功率とベクトル検証エラー |
| Shadow-read | Old + new embeddings | User sees old, logs new | Top-k overlap、レイテンシ、問題のあるクエリケース |
| Cutover | Old + new embeddings | New index | 関連性の合格率と p95 レイテンシ目標 |
| Rollback | Keep dual-write active | Switch back to old | エラースパイクまたは関連性低下でトリガー |
出典:Crazyrouter ナレッジベース(text-embedding-3-small は 1536 次元、OpenAI-compatible API、300+ supported models)。
これが text-embedding-3-small Dimensions Explained の実践的な核心です。次元を固定し、シャドウトラフィックでテストし、測定された同等性を確認してから切り替えます。
本番運用:ドリフト、品質回帰、チームワークフローの監視#
オフラインテストで次元サイズを選びました。良い出発点です。本当のリスクは、新しいコンテンツ、新しいクエリ構成、ランキング変化が本番に入った後に現れます。text-embedding-3-small Dimensions Explained では、長期的な品質は、固定された評価データ、ライブ挙動のチェック、制御されたロールアウト手順という密なループから生まれます。
text-embedding-3-small の次元ドリフト監視を設定する#
各次元変更の前に、評価セットと指標を固定します。実際のユーザー意図に合うゴールデンクエリセットを維持し、毎週同じ評価基準で採点します。それをライブシグナルと組み合わせることで、サポートチケットが積み上がった後ではなく、早期にドリフトを検知できます。
| シグナル | ドリフトの見え方 | レビュー頻度 | アクショントリガー |
|---|---|---|---|
| ゴールデンセット関連性スコア | 上位結果が既知の正解と一致しなくなる | 週次スコアカード | 最後の安定実行からの低下 |
| 検索ブロックの CTR | ユーザーが提案文書をクリックしなくなる | 日次 | 継続的な低下 |
| タスク成功率 | 目標タスクを完了できないセッションが増える | 日次 | セグメント別の下降傾向 |
| 結果なし率 | 空の検索レスポンスが増える | 日次 | デプロイ後のスパイク |
表の出典:このセクションで使用した運用ランブックパターン(提供されたアウトラインの golden set + online metrics)。
<.-- IMAGE: 週次ゴールデンセットスコア、CTR トレンド、結果なし率、アラートしきい値を示すダッシュボードモック -->
ステージングと本番で text-embedding-3-small の次元実験を安全に実行する#
直近 7〜14 日の再生クエリを使ってステージングから始めます。本番ではカナリアスライスに移行し、その後ユーザーセグメントと地域ごとに拡大します。ロールバックは常に準備しておきます。品質が低下した場合は、トラフィック拡大を停止し、最後に安定していた次元へ切り替え、失敗したクエリタイプを記録します。これによりインシデントを短く保ち、次のテストに向けたきれいなデータを得られます。
text-embedding-3-small Dimensions Explained 実験のためのチームワークフロー#
部門横断の評価は、混在したブラウザセッションでテストするために壊れがちです。SEO、プロダクト、ML が互いの状態を上書きし、その結果を誰も信頼できなくなります。DICloak の分離プロファイルを使えば、各ロールがセッション競合やアカウントの混線なしに同じビルドをテストできます。
DICloak のようなツールでは、プロファイルごとに固定プロキシとセッションルールを設定できます。つまり、"US-English account" と "EU account" のテストを毎回安定したネットワーク条件で実行できます。再現可能なセットアップにより、次元に基づくランキングチェックをチームメイト間で比較しやすくなり、継続的な text-embedding-3-small Dimensions Explained 作業のための反復可能で安全な経路が得られます。
よくある失敗と最終的な次元選定チェックリスト#
ここまで読んだなら、text-embedding-3-small Dimensions Explained は勘ではなくローンチ判断で終わるべきです。
本番を壊す text-embedding-3-small の次元選定ミス#
| 失敗 | 何が問題になるか | 何をすべきか |
|---|---|---|
| ベンダーベンチマークスコアだけを信じる | テストでは検索が良く見えるが、実際のクエリでは意図を外す | 実ユーザークエリから内部評価セットを作り、そのセットで各次元設定を採点する |
| ストレージコストを削減し、品質チェックを省く | ベクトルサイズを下げると費用は節約できるが、クリック品質が落ち、サポートチケットが増える | ロールアウト前に検索品質とユーザー行動を一緒に追跡する |
| 関連性だけをテストする | 高速なインデックス設定でも p95 目標を満たせない場合がある | エンドツーエンドのレイテンシを測る:embed + index search + rerank |
text-embedding-3-small Dimensions Explained の本番投入に向けた最終 10 項目チェックリスト#
- ソースデータの重複と壊れたテキストを整理する。
- ベンチマークで head、mid、tail のクエリをカバーする。
- 少なくとも 2 つのサイズを比較する:1536(text-embedding-3-small)と 3072(text-embedding-3-large)。
- 同じクエリセットで各サイズの top-k 関連性を記録する。
- API 呼び出しから最終ランキング結果までの p95 レイテンシを記録する。
- 次元数を 100 万ベクトルあたりのストレージコストに換算する。
- 実トラフィックと成功指標でカナリアを実行する。
- フルロールアウト前にロールバック手順を準備する。
- 監視とアラート対応の担当者を 1 人割り当てる。
- 再学習または再埋め込みのレビュー頻度を設定する。
関連性、p95 レイテンシ、ストレージコストがすべて合格したときだけ出荷してください。
<.-- IMAGE: 埋め込み次元の意思決定のための 1 ページローンチチェックリスト図。 -->
よくある質問#
text-embedding-3-small Dimensions Explained では、最初に使うべき最適なデフォルト次元は何ですか?#
実用的な出発点は、多くのチームでは 512、コンテンツが複雑な場合(法務、技術、長文ドキュメント)は 1024 です。text-embedding-3-small Dimensions Explained では、これにより早い段階で過剰にコミットせずに、品質、速度、コストの強いバランスが得られます。その後、実際のユーザークエリと想定フィルタを使って小さなベンチマークを実行します。簡易テストで最も良く見えるものではなく、関連性目標を満たす最小の次元を選んでください。
text-embedding-3-small Dimensions Explained で次元を下げると、常に検索品質は低下しますか?#
低次元が必ず意味のある形で結果を悪化させるわけではありません。短い FAQ 検索や狭いドメインでは、低下が小さい場合があります。広いカタログ、多言語コンテンツ、ニュアンスのある意味マッチングでは、品質がより早く落ちる可能性があります。text-embedding-3-small Dimensions Explained では、次元を調整つまみとして扱います。同じクエリセットで 256、512、1024 を比較してください。実ユーザーにとって許容できる Recall@k とランキング品質を保てる最小サイズを維持します。
text-embedding-3-small の次元はベクトルデータベースのコストにどう影響しますか?#
コストは次元数にほぼ線形に比例します。ベクトルを 1024 から 512 に削減すると、生のベクトルストレージは約半分になります。同じ傾向は RAM 使用量や、多くの場合クエリ計算にも当てはまります。ただし、インデックスのオーバーヘッドも含めてください。ANN 構造は、グラフリンク、メタデータ、内部管理のためにメモリを追加します。そのため総削減効果は大きいものの、ベクトルバイトだけではありません。実務では、最終的な次元を設定する前に、埋め込みサイズだけでなくフルインデックスサイズを見積もります。
次元を変更するとき、すべてのドキュメントを再埋め込みする必要がありますか?#
はい。ある次元で作られたベクトルを、別の次元のベクトルと同じ一貫したインデックス内で混在させることはできません。次元を変更するときは、すべてのドキュメントを再埋め込みし、インデックスを再構築します。本番システムでは、より安全な移行として二重インデックスのロールアウトを使います。新しいインデックスを並行して構築し、トラフィックの一部をそこへ送り、品質とレイテンシを比較してから完全に切り替えます。これによりダウンタイムを避け、移行中の検索挙動を安定させられます。
次元を比較するとき、どの指標を追跡すべきですか?#
関連性、速度、コストの 3 グループを追跡します。関連性では、ラベル付きクエリセット上で Recall@k、nDCG、MRR を使います。速度では、テールレイテンシがユーザー体験に影響するため、p50/p95/p99 レイテンシを監視します。コストでは、100 万ドキュメントあたりのストレージ、RAM フットプリント、1,000 クエリあたりのコストを測定します。text-embedding-3-small Dimensions Explained では、このスコアカードにより、ストレージを節約する一方でランキング品質を大きく損なうような一面的な選択を避けられます。
text-embedding-3-small は低次元で多言語検索に適していますか?#
機能する場合はありますが、多言語検索では単一言語検索より厳密なテストが必要です。低次元では、特に短いクエリや混在スクリプトで、言語間の微妙な意味が統合されてしまう可能性があります。512 または 1024 から始め、言語ペア、クエリ長、ドメイン用語ごとにテストしてください。text-embedding-3-small Dimensions Explained では、精度が重要な多言語構成は、より大きな次元の恩恵を受けることがよくあります。主要な各言語セグメントで関連性目標を満たす最小設定を選びます。
重要なポイントは、text-embedding-3-small の次元が実践的な調整レバーであるということです。高い次元は意味の忠実度を改善できる一方、低い次元はストレージ、レイテンシ、コストを削減します。そのため適切な選択は、検索品質目標とシステム制約に依存します。デフォルトに頼るのではなく、自分たちのデータで recall、ランキング品質、エンドツーエンド性能をベンチマークし、次元サイズを実証的に決めてください。今週、自分たちのパイプラインで複数の次元をテストし、勘ではなく根拠をもって本番設定を固定しましょう。
Implementation Guides
Available in other languages: